FILMLAB · Hallazgos
Las pruebas detrás del manual: cada serie de mediciones con fecha, cada fallo con nombre y, para casi cada característica del producto, la medición que la originó. Si quieres saber cómo se usa algo, el manual es el lugar; si quieres saber por qué está construido así y dónde falla, es aquí.
Tres preguntas que una página de producto tiene que responder antes de mostrar cualquier cosa. Aquí van primero, y el resto de la página las respalda.
Del exposé a un look listo para el pitch: historia, personajes, locaciones, imagen, movimiento, montaje, exportación. No una herramienta para clips, sino el recorrido intermedio, y la conexión con el presupuesto y la documentación de derechos.
Una tarde en lugar de tres semanas de trabajo conceptual. El precio está antes de enviar, no en la factura. Y lo que la herramienta puede hacer está medido y se puede consultar, en lugar de afirmado.
Directores independientes y autoras con un exposé que tiene que volverse visual. Productoras de dos a quince personas que presentan de tres a diez proyectos al año. Publicidad y video institucional, donde un concepto de look tiene que estar antes del rodaje.
El motivo por el que se paga no es la creatividad, sino la presión de plazos con dinero detrás: fecha límite de postulación, cita de pitch, presentación al cliente. Quien tiene que entregar la semana que viene no compara seis herramientas: paga por estar listo para el pitch el viernes.
Y lo que no va a ser, para que no esperes lo equivocado: no otro zoológico de modelos, no una competencia por el mejor modelo de video, no una guerra de precios contra proveedores de tarifa plana. Quien solo quiere clips en cadena está mejor servido en otro lado, por menos. El valor está en la planificación y en el contexto DACH.
El mismo orden que en la proyección, donde un solo plano recorre todas las etapas. Aquí, la vista general.
La historia, las personas, los lugares. Lo que un equipo aclara en la mesa antes de montar una cámara.
Prompt, imagen, movimiento, audio. Aquí nace lo que se puede ver, y aquí están los costos.
Los planos se vuelven una secuencia, y la secuencia una película en los formatos que alguien aprueba.
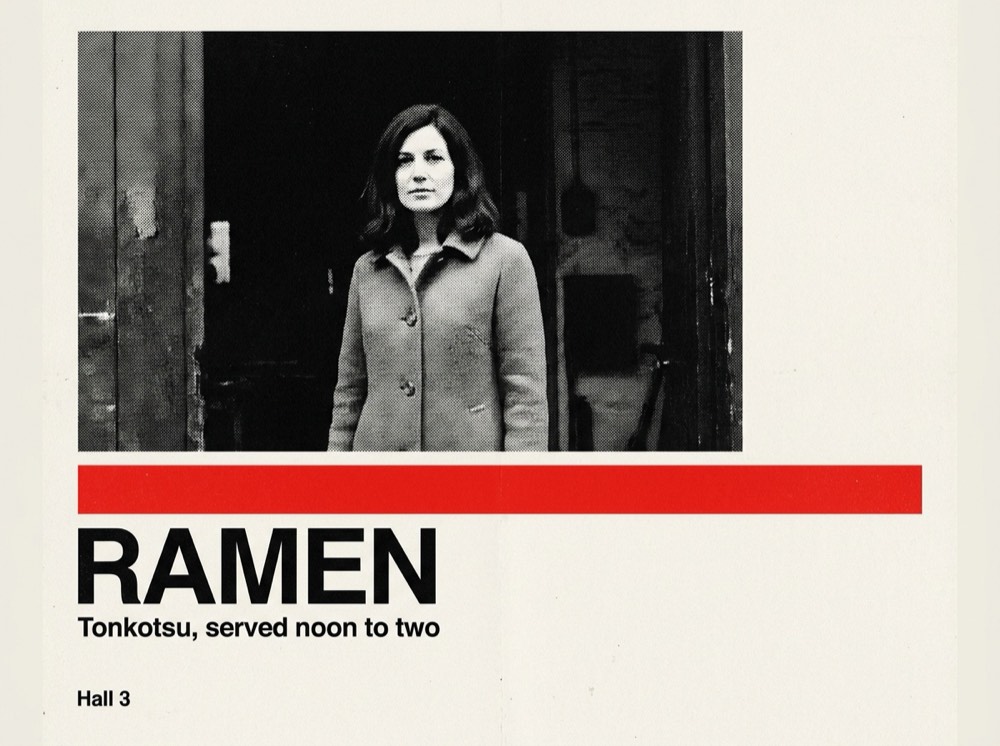
Film stocks (Portra, Cinestill, Tri-X …), looks cinematográficos y estilos gráficos que reescriben toda la imagen: cartel Bauhaus, cel de anime, gofrado en seco, serigrafía. Los presets con tipografía fija tienen campos de entrada: las palabras en la imagen son tuyas, no nuestras.
48 presets, cada uno con imagen de referencia sobre el mismo motivoParámetros curados en lugar de wrappers de prompt genéricos: cada preset lleva la firma de un oficio. Legible al instante para la gente de cine, porque habla el idioma del set y no el del modelo.
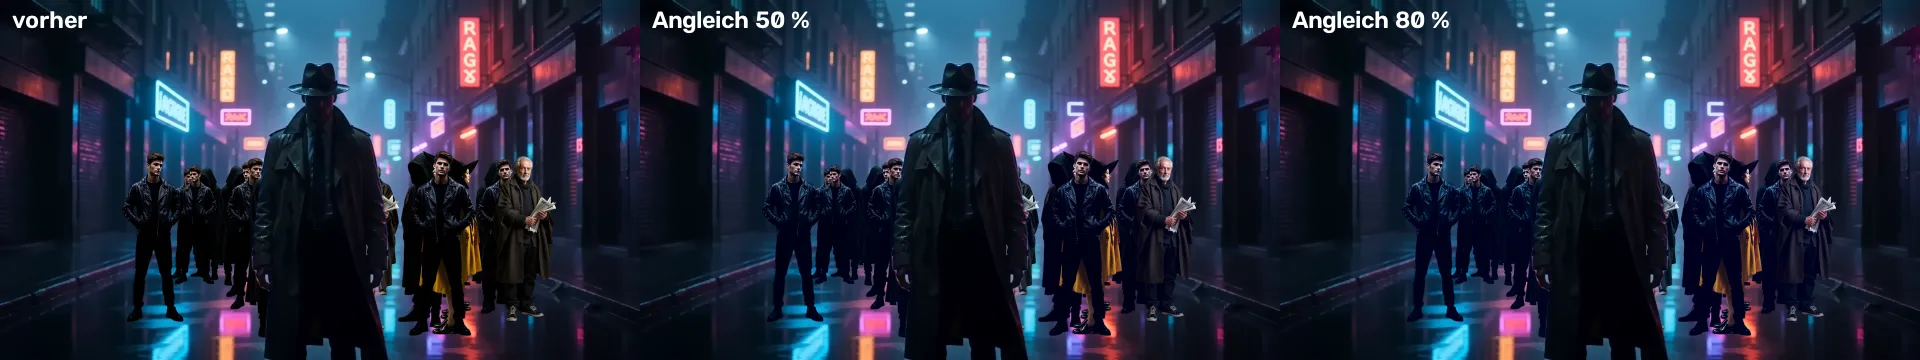
Exposición, contraste, tono, saturación, grano: como controles, no como prompt. La corrección de color se calcula directamente sobre la imagen: el mismo look afecta igual a cada still, de forma reproducible y sin gastar un Credit, porque ya no hay un modelo adivinando. “Partir del brief del colorista” toma como punto de partida el look de la configuración del equipo, y los controles afinan encima. La misma corrección de color existe como herramienta MCP lab_grade: un agente de IA aplica el look con los mismos controles, sin abrir la app.
70 looks. Veinte son de diseño libre, 17 de ellos con nombre en tres familias:
Además, tres técnicos para material que llega como Cineon log (log-neutral, print-warm, print-kühl): esperan log y entregan Rec.709; sobre material normal se ven mal.
Los otros cincuenta son looks de referencia, desde el 27 de septiembre: cada uno reconstruido a partir de un fotograma concreto, con tres colores guía de la imagen y nuestra matemática de corrección de color (curva, saturación, grano), horneado como LUT propia. En la consola, cada uno aparece con su fotograma y el dato exacto debajo: película, año, dirección, cámara. Se elige por la película; por eso el acompañante no lo propone según el motivo. La lista completa está bajo las herramientas.
Aplicar no es destructivo: el original se conserva y la imagen con corrección de color es una nueva fila en la galería. El acompañante (agente de pipeline) propone un look y lo aplica con aprobación: guiado en la consola o en el chat (“¿qué look le queda a este plano?”).
70 looks (20 de diseño libre, 50 según fotograma) · en la consola, como herramienta MCP lab_grade, a través del acompañante · determinista, sin Credits de IA · en producción desde 2026-09-21El router ordena por calidad según cada intención, pone un tope a los costos y, dentro de una familia de modelos, toma el acceso conectado más barato. Si no encuentra ninguno bajo el tope, lo dice con cifras, en lugar de tomar en silencio el modelo más caro.
El precio antes de enviar, no despuésTimeline, transporte, dos monitores, exportación. Los planos del pipeline llegan directamente ahí, sin pasar por una carpeta de descargas.
La app en el navegador. Un servidor MCP a través del cual agentes de IA manejan el mismo pipeline: 82 herramientas. Y un puente que corre dentro de DaVinci Resolve y que desde el 27 de septiembre forma con el MCP una fachada común: un agente ve FilmLab y la timeline abierta de Resolve al mismo tiempo. Lo que cuesta dinero se hace ahí en dos pasos: primero el precio, luego una aprobación que vale solo para exactamente esa llamada y durante quince minutos.
App · MCP (OAuth o clave del puente) · puente de Resolve 0.67 · detalles abajoCada look lleva el número con el que aparece en la consola (filmlab-ref-01 a -50). Los fotogramas los mostramos solo en la consola, como prueba de en qué se basó el look; los derechos de las imágenes pertenecen a los titulares de derechos de las películas.
| Nr. | Film | Año | Dirección | Cámara |
|---|---|---|---|---|
| 01 | American Honey | 2016 | Andrea Arnold | Robbie Ryan |
| 02 | Drive | 2011 | Nicolas Winding Refn | Newton Thomas Sigel |
| 03 | Aftersun | 2022 | Charlotte Wells | Gregory Oke |
| 04 | Sicario | 2015 | Denis Villeneuve | Roger Deakins |
| 05 | Aftersun | 2022 | Charlotte Wells | Gregory Oke |
| 06 | The Florida Project | 2017 | Sean Baker | Alexis Zabé |
| 07 | The Florida Project | 2017 | Sean Baker | Alexis Zabé |
| 08 | Fish Tank | 2009 | Andrea Arnold | Robbie Ryan |
| 09 | Fish Tank | 2009 | Andrea Arnold | Robbie Ryan |
| 10 | Fish Tank | 2009 | Andrea Arnold | Robbie Ryan |
| 11 | This Is England | 2006 | Shane Meadows | Danny Cohen |
| 12 | This Is England | 2006 | Shane Meadows | Danny Cohen |
| 13 | This Is England | 2006 | Shane Meadows | Danny Cohen |
| 14 | Under the Skin | 2013 | Jonathan Glazer | Daniel Landin |
| 15 | Portrait of a Lady on Fire | 2019 | Céline Sciamma | Claire Mathon |
| 16 | Portrait of a Lady on Fire | 2019 | Céline Sciamma | Claire Mathon |
| 17 | The Master | 2012 | Paul Thomas Anderson | Mihai Malaimare Jr. |
| 18 | Blade Runner 2049 | 2017 | Denis Villeneuve | Roger Deakins |
| 19 | In the Mood for Love | 2000 | Wong Kar-wai | Christopher Doyle / Mark Lee Ping-Bing |
| 20 | In the Mood for Love | 2000 | Wong Kar-wai | Christopher Doyle / Mark Lee Ping-Bing |
| 21 | In the Mood for Love | 2000 | Wong Kar-wai | Christopher Doyle / Mark Lee Ping-Bing |
| 22 | Drive | 2011 | Nicolas Winding Refn | Newton Thomas Sigel |
| 23 | Buffalo '66 | 1998 | Vincent Gallo | Lance Acord |
| 24 | The Master | 2012 | Paul Thomas Anderson | Mihai Malaimare Jr. |
| 25 | Sicario | 2015 | Denis Villeneuve | Roger Deakins |
| 26 | Uncut Gems | 2019 | Josh & Benny Safdie | Darius Khondji |
| 27 | The Neon Demon | 2016 | Nicolas Winding Refn | Natasha Braier |
| 28 | Moonlight | 2016 | Barry Jenkins | James Laxton |
| 29 | The Florida Project | 2017 | Sean Baker | Alexis Zabé |
| 30 | Drive | 2011 | Nicolas Winding Refn | Newton Thomas Sigel |
| 31 | Good Time | 2017 | Josh & Benny Safdie | Sean Price Williams |
| 32 | American Honey | 2016 | Andrea Arnold | Robbie Ryan |
| 33 | Chungking Express | 1994 | Wong Kar-wai | Christopher Doyle / Andrew Lau |
| 34 | Chungking Express | 1994 | Wong Kar-wai | Christopher Doyle / Andrew Lau |
| 35 | Good Time | 2017 | Josh & Benny Safdie | Sean Price Williams |
| 36 | Good Time | 2017 | Josh & Benny Safdie | Sean Price Williams |
| 37 | Uncut Gems | 2019 | Josh & Benny Safdie | Darius Khondji |
| 38 | Uncut Gems | 2019 | Josh & Benny Safdie | Darius Khondji |
| 39 | Paris, Texas | 1984 | Wim Wenders | Robby Müller |
| 40 | Paris, Texas | 1984 | Wim Wenders | Robby Müller |
| 41 | The Neon Demon | 2016 | Nicolas Winding Refn | Natasha Braier |
| 42 | The Neon Demon | 2016 | Nicolas Winding Refn | Natasha Braier |
| 43 | Buffalo '66 | 1998 | Vincent Gallo | Lance Acord |
| 44 | Under the Skin | 2013 | Jonathan Glazer | Daniel Landin |
| 45 | Under the Skin | 2013 | Jonathan Glazer | Daniel Landin |
| 46 | Moonlight | 2016 | Barry Jenkins | James Laxton |
| 47 | Moonlight | 2016 | Barry Jenkins | James Laxton |
| 48 | Blade Runner 2049 | 2017 | Denis Villeneuve | Roger Deakins |
| 49 | Blade Runner 2049 | 2017 | Denis Villeneuve | Roger Deakins |
| 50 | Paris, Texas | 1984 | Wim Wenders | Robby Müller |
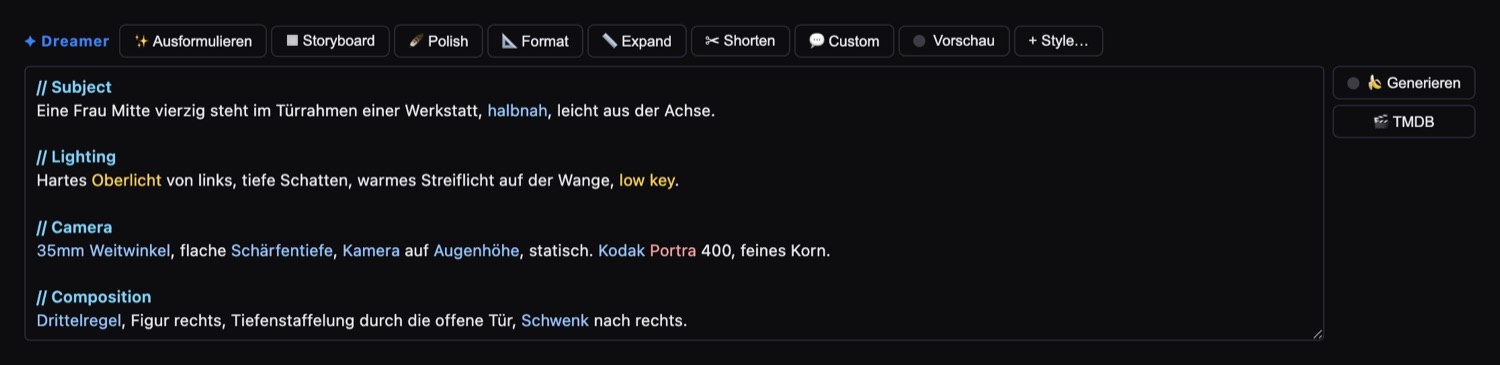
Cada etapa depende del prompt, y el prompt es el lugar donde se queman la mayoría de los intentos. Por eso el Dreamer no es un campo de texto, sino una caja de herramientas.
Construir a partir de una idea un prompt completo y estructurado: luz, óptica y cámara se agregan en lugar de olvidarse.
Descomponer una escena en cuatro a ocho paneles numerados, cada uno un prompt de imagen independiente con tamaño de plano y ángulo.
Estructurar en secciones, suavizar la fluidez del texto, agregar detalles cinematográficos o acortar alrededor de un tercio: el núcleo se mantiene.
Luz, óptica, cámara, material, color, composición, movimiento y estilo se colorean en el texto, alimentados por el léxico de cine. Se ve de qué habla el prompt y de qué no.
Film stocks, looks cinematográficos, estilos gráficos. Los presets que ponen texto en la imagen tienen campos de entrada: las palabras de la imagen son tuyas.
Una imagen de prueba diminuta del prompt por alrededor de un tercio de centavo. No se guarda; solo responde la pregunta de si el prompt funciona.
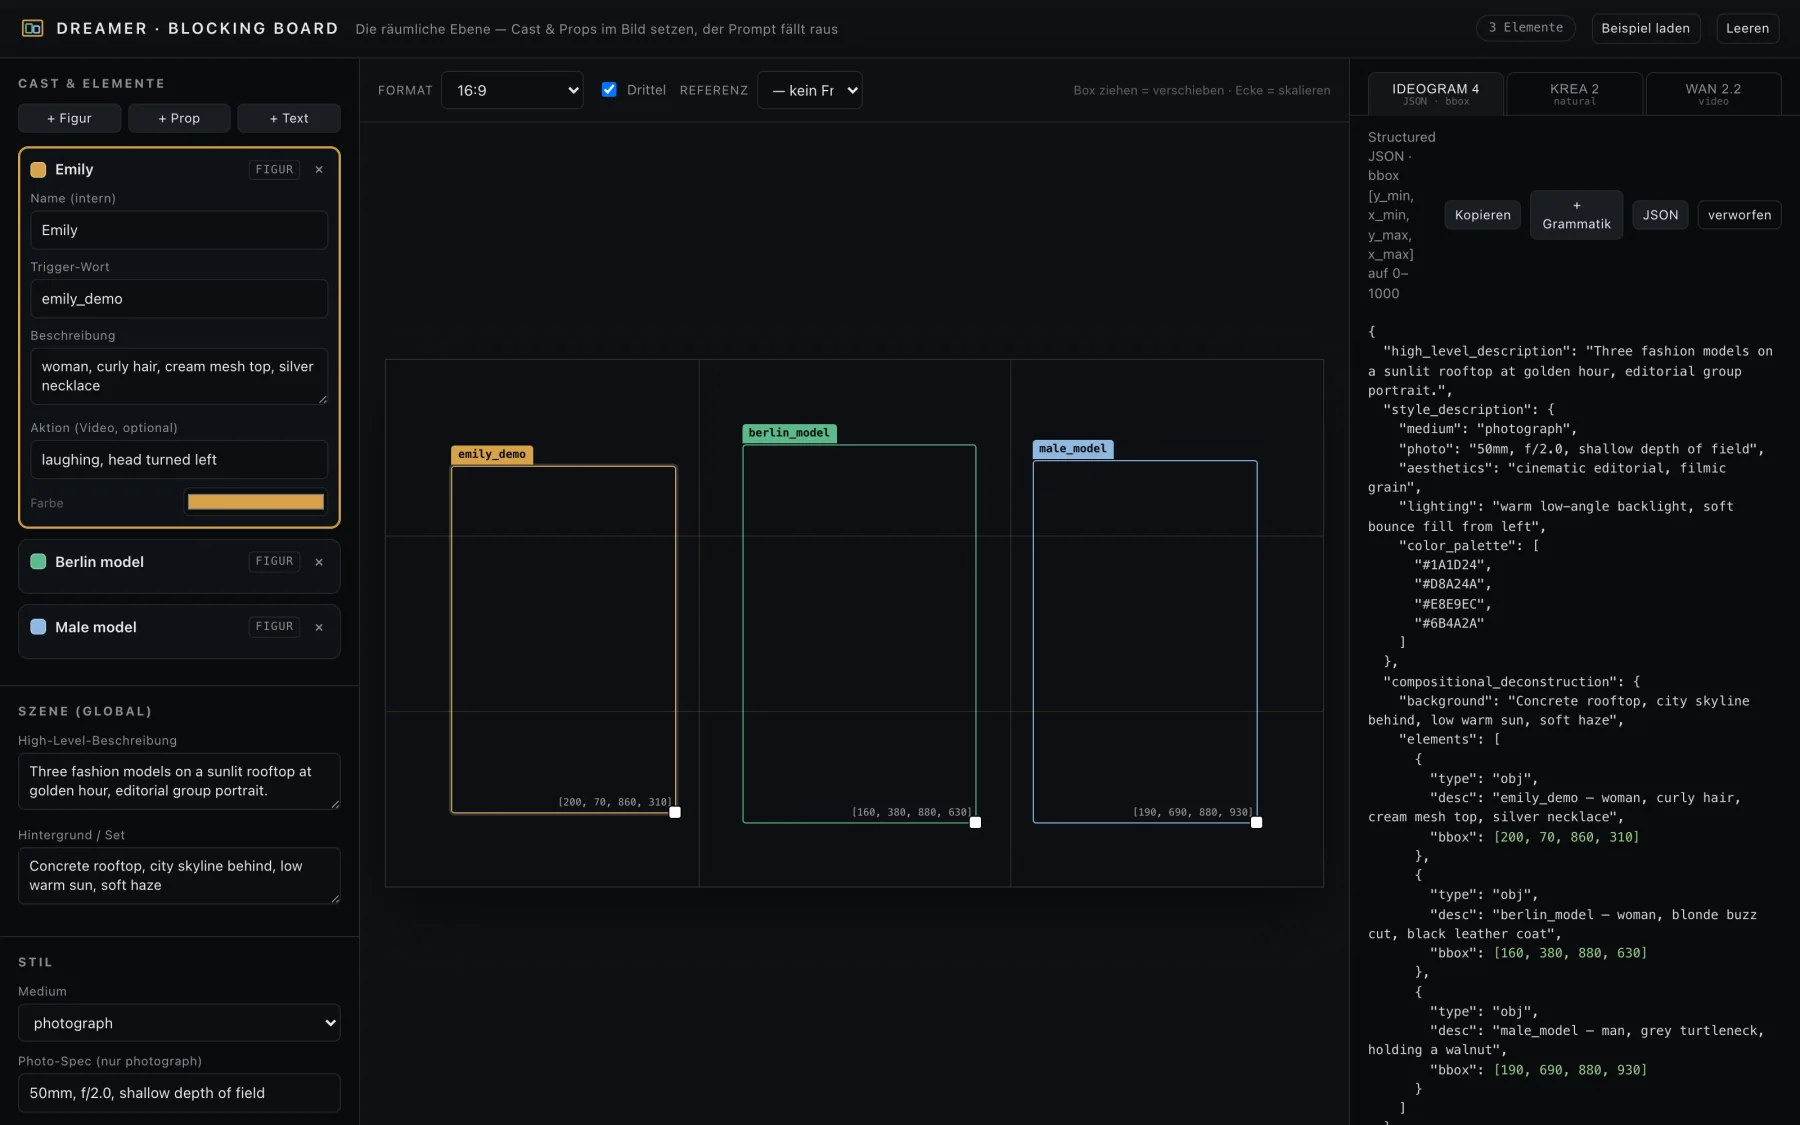
~$0,003 por vistazoEn el Blocking Board, los personajes y la utilería se ubican en el encuadre en lugar de describirse. El prompt queda como subproducto: ver abajo.
Cada paso es reversible, hasta veinte hacia atrás. Quien prueba tiene que poder volver; si no, no prueba.
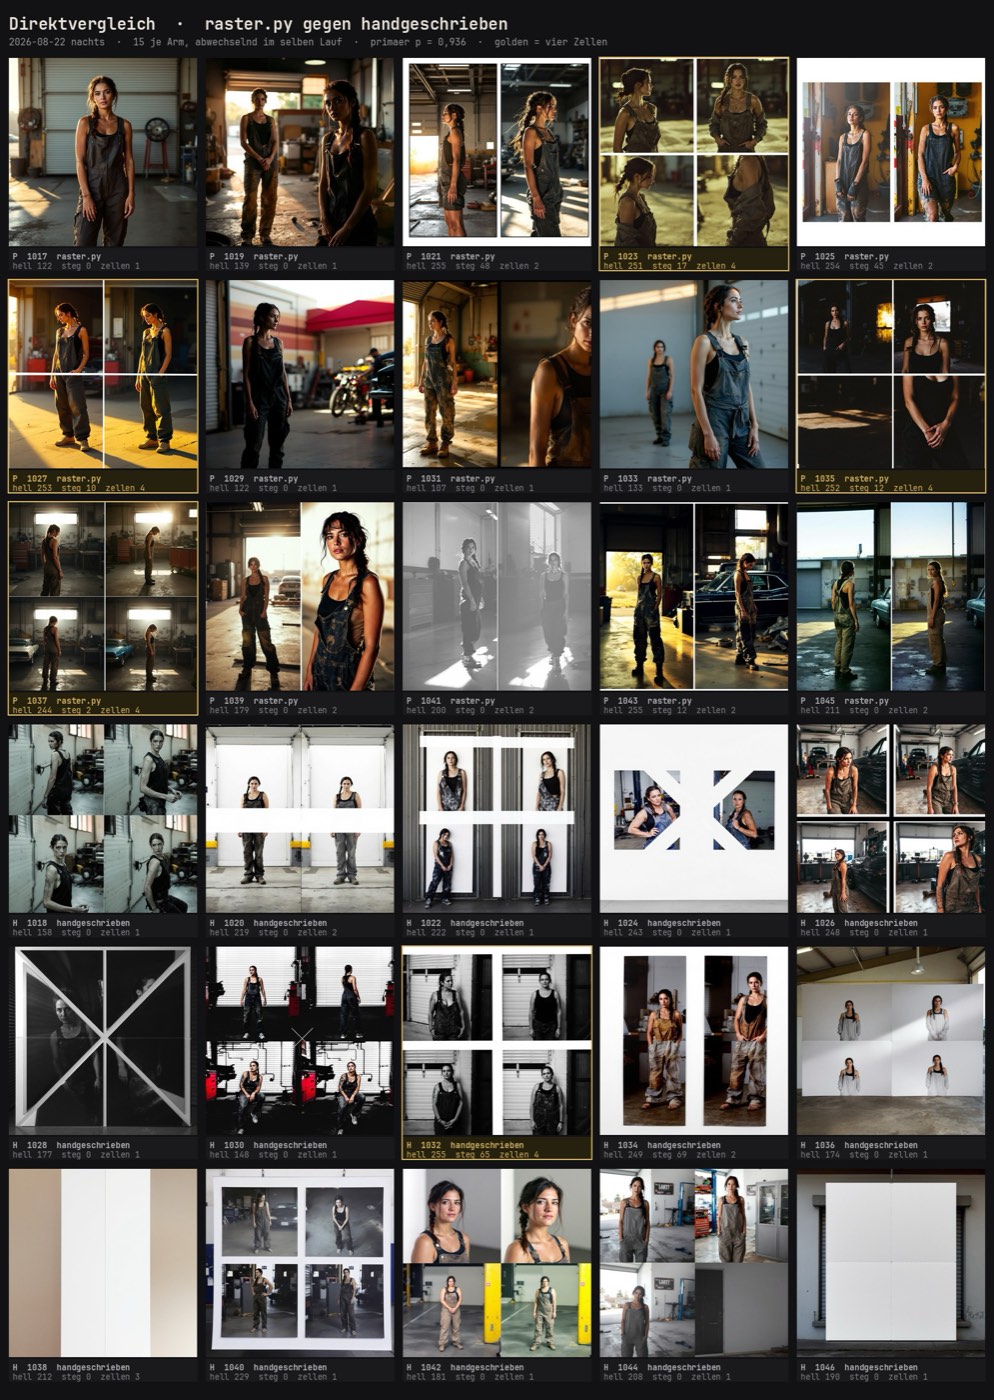
Por qué esto es una caja de herramientas y no un automatismo: medimos si un prompt escrito a mano funciona mejor que uno generado: 110 tiradas, tres intentos, ninguna diferencia. Las herramientas, entonces, no crean calidad de la nada; ahorran intentos. Esa es la promesa honesta, y vale más que la otra.
Casi cada característica aquí tiene una medición como causa, a menudo una que salió en contra de lo que esperábamos. La serie, de izquierda a derecha: cuándo, qué se midió, qué salió de ello en el producto.
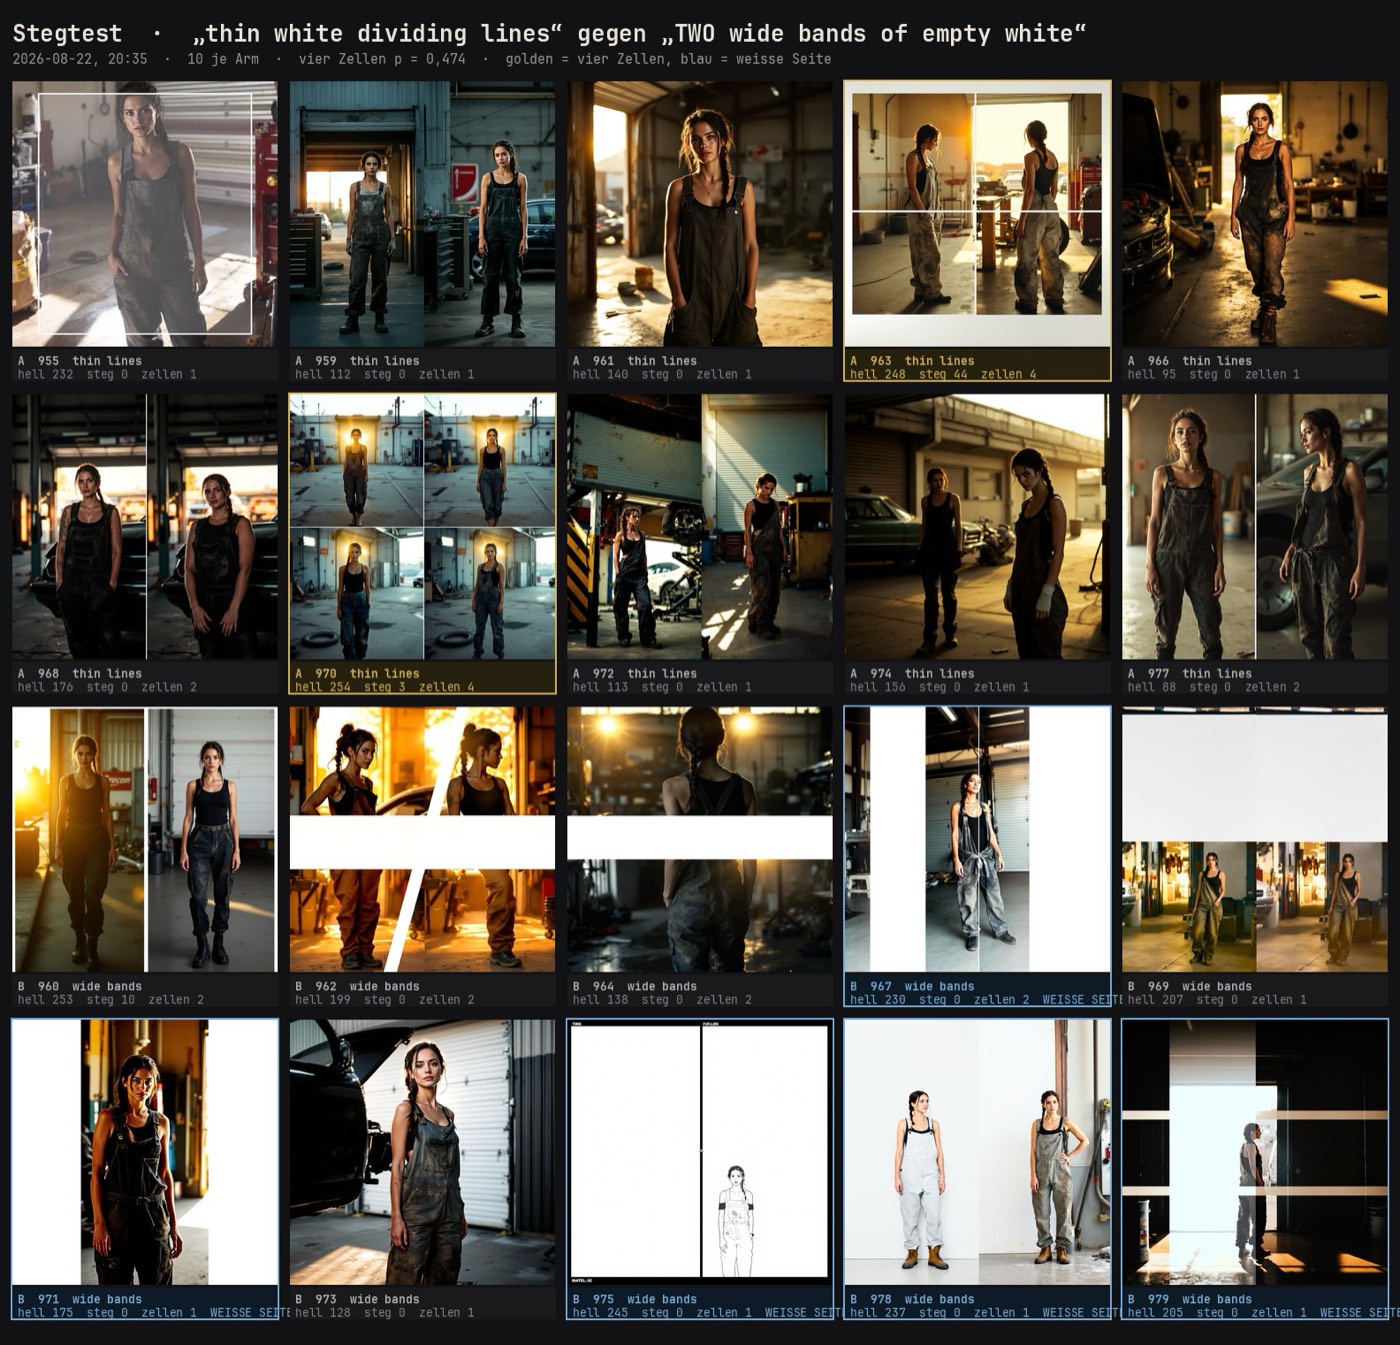
Siempre con el mismo patrón: una pregunta, dos grupos, lanzados de forma alterna en la misma ejecución; si no, se mide el estado del día del modelo y no la cuestión. Al final, una hoja de contactos en la que cada tirada aparece con sus valores medidos, para que se pueda reconstruir qué se contó.
Lo que cuesta medir. La noche del 22 de agosto: 110 tiradas, unos 8,80 US$. La ronda de estilos del 2 de septiembre: 18 generaciones, 2,70 US$. En total, menos que un solo trabajo de cliente mal adivinado.
Y por qué esto está aquí. Porque una herramienta que solo muestra sus aciertos te deja encontrar los huecos a ti, en el peor caso el día antes de la entrega.
48 en total, todos renderizados con el mismo motivo. Solo así la diferencia es el estilo y no el motivo, y solo así se nota cuando uno no hace lo que dice.
Quince nuevos estilos gráficos, cada imagen revisada y cada palabra en ella leída:
La desviación más frecuente es inofensiva y recurrente: el afiche sale como un objeto fotografiado en lugar de ocupar todo el cuadro. La poco frecuente no lo es, y los dos casos están abajo.
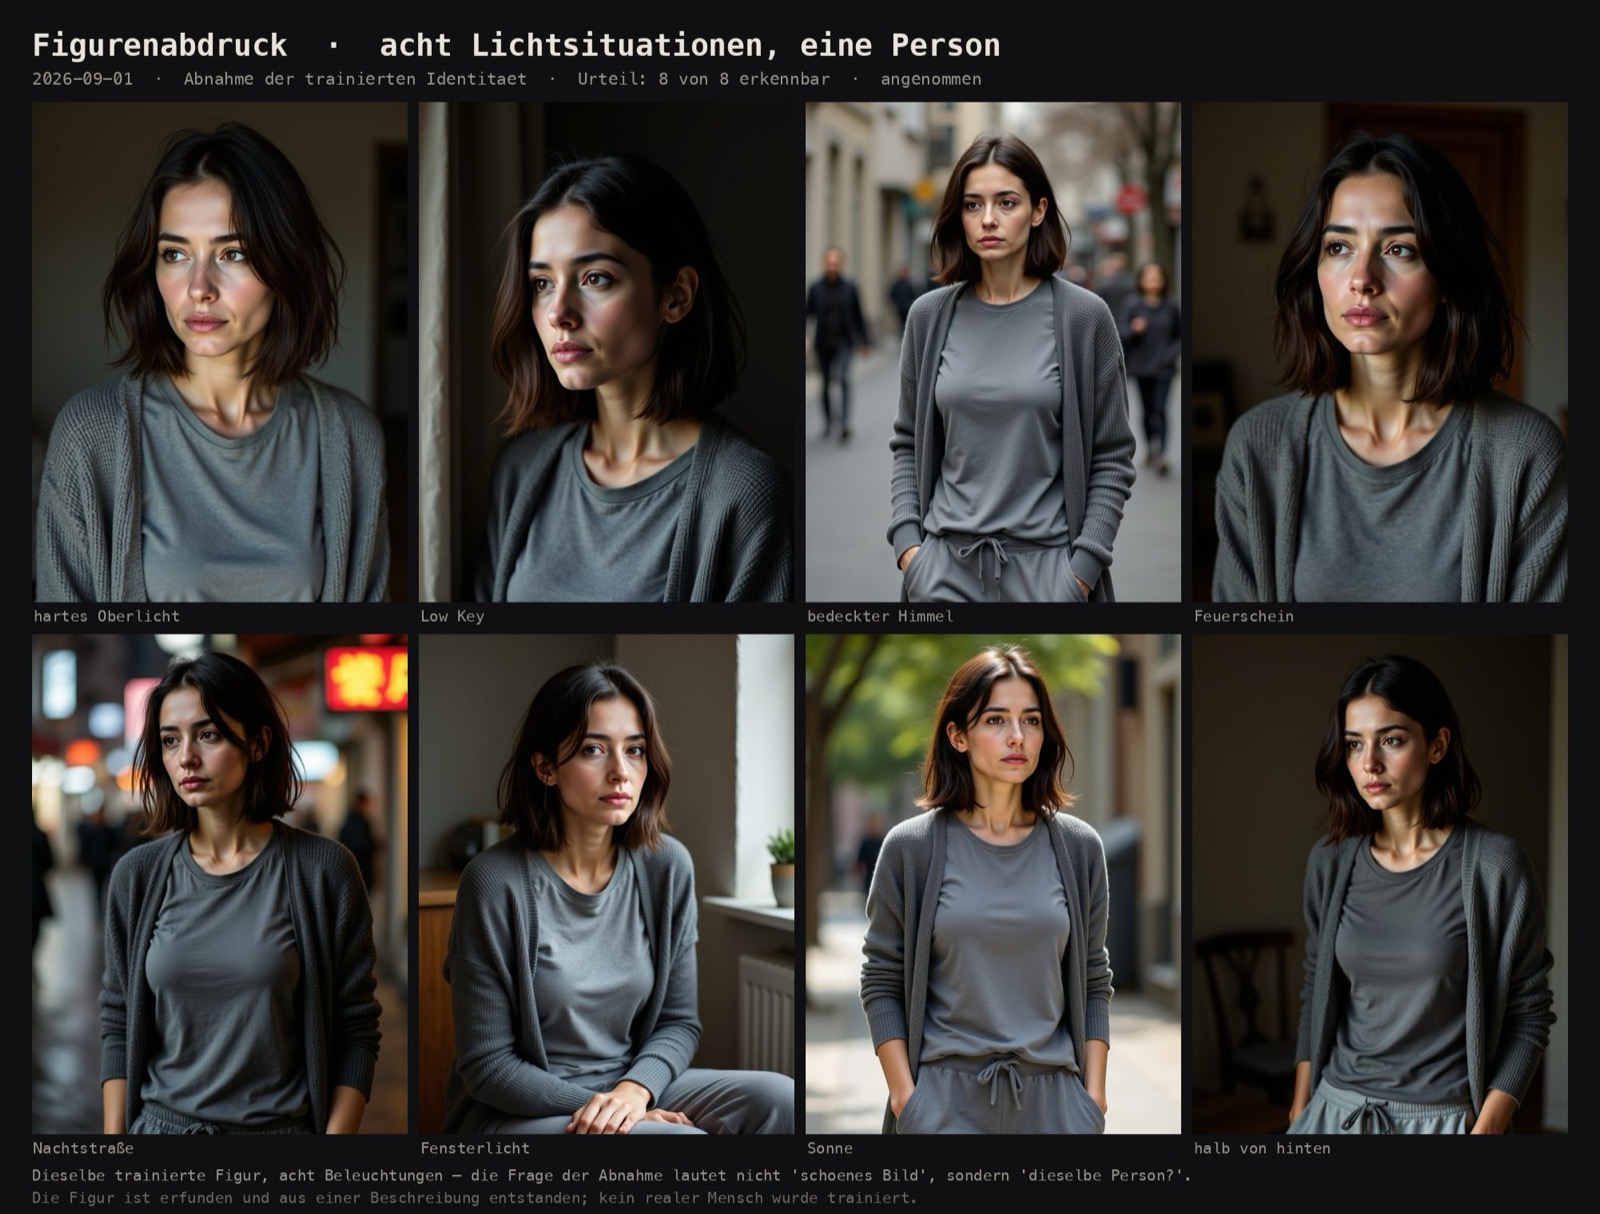
Un personaje que se ve distinto en la segunda imagen que en la primera no es un personaje. La huella es la identidad entrenada: se crea una vez y después se puede recuperar en cualquier plano.
La identidad de un personaje se mantiene mediante una imagen de referencia, no repitiéndola en el texto. Funciona tan bien que genera su propio problema: la referencia también se impone a lo que no debería. Medimos cuándo: con un personaje, cuatro planos, diez ejecuciones por grupo, con el criterio fijado de antemano.
Las dos que se rompieron eran etiquetas: “full side profile” y “dynamic action pose”, nombres de planos que un modelo también asigna con generosidad. Las dos que se mantuvieron ya describían mecánica: “hands resting on thighs”, “mid-stride toward camera”. La referencia no se come una postura. Se come una etiqueta.
En la práctica, esto significa que los puntos conflictivos se pueden leer en la formulación, en lugar de tener que medirlos uno por uno. Si dice lo que debe verse, se mantiene. Si dice el nombre de un plano, gana la imagen de referencia.
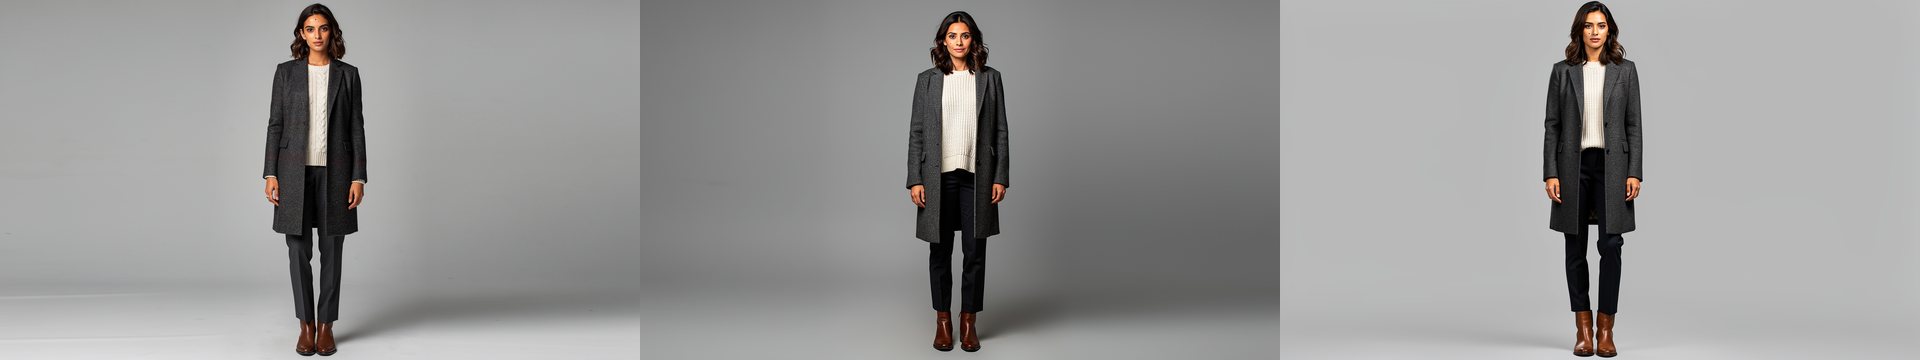
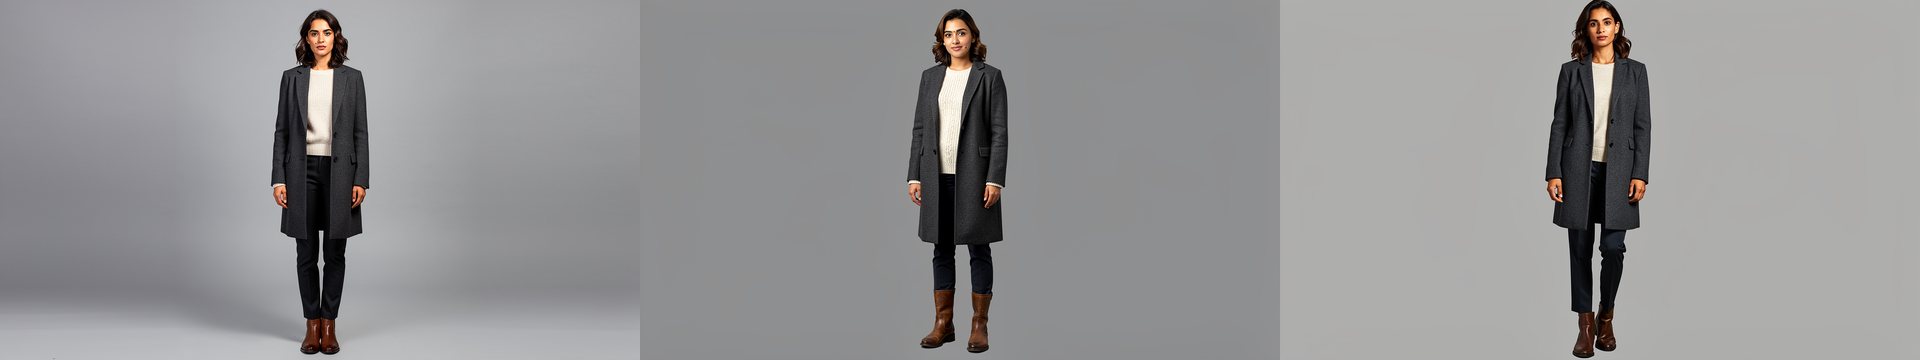
Una hoja es una referencia, no una imagen terminada. Todo lo que contiene en cuanto a luz (una sombra proyectada, un suelo que se pierde hacia el horizonte) lo hereda cada escena posterior y tiene que pelear ahí contra la luz de la escena. Hasta ahora, las vistas de la hoja pedían un “fondo gris, luz de estudio uniforme”, es decir, un fondo fotografiado. Desde el 2026-10-01 piden un campo de color: un gris medio uniforme en cada píxel, sin suelo, pared ni horizonte, iluminado sin sombras, sin sombras ni derrame de luz fuera del personaje.
La medición: vista “cuerpo entero”, tres ejecuciones por grupo, brillo de las esquinas de la imagen y una franja en el suelo frente a una a la altura de la cabeza. Comprobado con referencia (ancla más otras cinco vistas, similitud facial frente al ancla), la identidad no empeoró: con la misma ancla para ambos grupos, 0,684 → 0,735, diferencia +0,05 con un intervalo del 95 % de −0,01 a +0,12 (13 pares). La ganancia viene casi solo del perfil; sin él, las vistas son iguales. Eso es “ninguna pérdida”, no “una ganancia”.
El fallo que nosotros mismos habíamos introducido en el proceso.
Con el campo de color, el ancla de detalle (el retrato del que se derivan todas las demás vistas) dejó de ser un retrato en muchos personajes y pasó a ser una imagen de medio cuerpo o de cuerpo entero. Lo notamos al volver a medir la identidad con un personaje real: en una ejecución con otra ancla, “nuevo” de pronto se veía peor, y la causa no era el parecido sino el encuadre. El texto descriptivo del personaje (aquí: “Standing at full length, the whole figure inside the frame, both shoes fully visible”, en otro: “trousers and brown leather boots”) se impone a la indicación “retrato grande”, y la frase sobre “el personaje” en el campo de color no lo remedia. Es la misma mecánica que con etiqueta y geometría: la referencia, aquí el texto, se impone a la indicación.
La corrección está desde el 2026-10-02 en las vistas “detail” y “detail_smile”: una frase al final que pone el encuadre de cabeza y hombros por encima de cualquier encuadre en el texto de descripción. Se considera cuerpo entero un rostro por debajo del 20 % de la altura de la imagen. Límites: el personaje 190 (real, diez ejecuciones por grupo) y dos personajes de prueba inventados (cinco ejecuciones cada uno) son una muestra pequeña; algunos recortes ahora son muy ajustados, y en una frente el pelo queda cortado. No se ha vuelto a medir qué tan bien mantienen la identidad las vistas siguientes con la nueva ancla. Las hojas ya guardadas no cambian; quien haya recibido un ancla de cuerpo entero debe generar la hoja de nuevo.
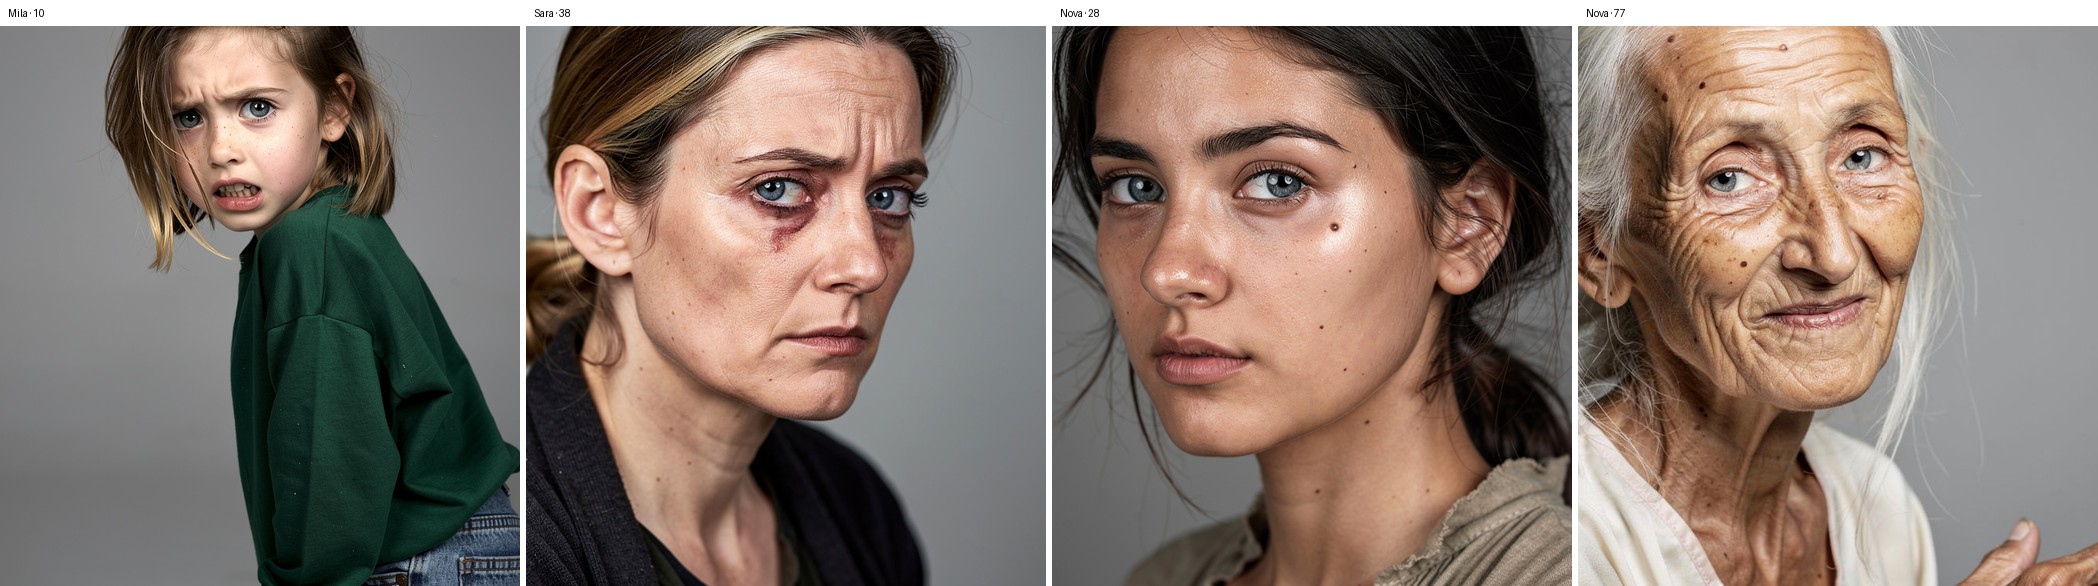
Un guion pedía para un personaje ambas cosas: una mujer de setenta y siete años en la cama y la misma mujer a los veintiocho, en flashbacks que sostienen un tercio del episodio. Dos personajes separados en el sistema, y con ello dos rostros que no tienen nada que ver entre sí.
La misma familia en cuatro hojas: hija, madre, abuela joven, abuela mayor. Las cuatro tienen el mismo color de ojos, y se transmite de forma visible.
“La misma persona, solo que más joven” no habría servido de nada: es otra vez una etiqueta. Y los rasgos no se pueden copiar del personaje mayor: “rostro delgado con pómulos altos” en una mujer de setenta y siete años está tallado por la edad y la trae consigo hacia atrás. El primer intento entregó, como era de esperar, a una mujer de cincuenta.
El descriptor es el texto del que surge cada imagen de un personaje, y es trabajo manual: uno del inventario tiene 1349 caracteres y se afinó tres veces en un día. Hasta el 2 de septiembre, esta columna no tenía historial: ni fecha de modificación, ni versiones. Una sobrescritura equivocada era definitiva, y la única protección eran archivos de respaldo creados a mano.
Ahora la base de datos registra por sí misma cada versión, con fecha y origen. A propósito en la base de datos y no en la aplicación: la herramienta de reparación con la que ese mismo día se repararon trece personajes escribe directamente en la tabla y habría esquivado una protección en la aplicación. Una protección que solo conoce los caminos conocidos no protege de la próxima herramienta. El inventario recibió su estado de entonces como primera versión: 189 personajes, para que también los que no se tocaron tengan un pasado.
El consentimiento es una puerta, no una casilla. Cada paso lo verifica, y la vía con fotos de una persona real está construida, pero no se puede recorrer sin un identificador del registro de Likeness. Una huella es la identidad de una persona: no surge de pasada.
¿Y si se retira el consentimiento? Entonces la vía se cierra de inmediato; si el registro no está disponible, la puerta también se considera cerrada, no abierta. En cambio, no se borra automáticamente, sino tras revisión: una lista lleva cada huella cuyo consentimiento ya no la respalda y la vuelve a señalar en cada revisión hasta que desaparezca. Desde el 27 de septiembre, al borrar también se elimina el archivo de entrenamiento con las fotos; antes se quedaba. Lo que permanece en el proveedor de entrenamiento después de la ejecución no lo alcanza nuestro borrado; lo decimos aquí porque si no nadie lo dice.
Y lo que nos costó esta única ejecución: ocho errores que ninguna suite de pruebas en verde habría encontrado (un límite de tiempo medido con el modelo más rápido, un precio que volvía en silencio al valor de referencia, una red para devolver Credits que se saltaba porque la excepción pasaba por encima). Los ocho salieron solo de ejecuciones reales con dinero real.
Poner en movimiento una imagen fija es el paso del que depende más dinero. Por eso está medido y no adivinado.
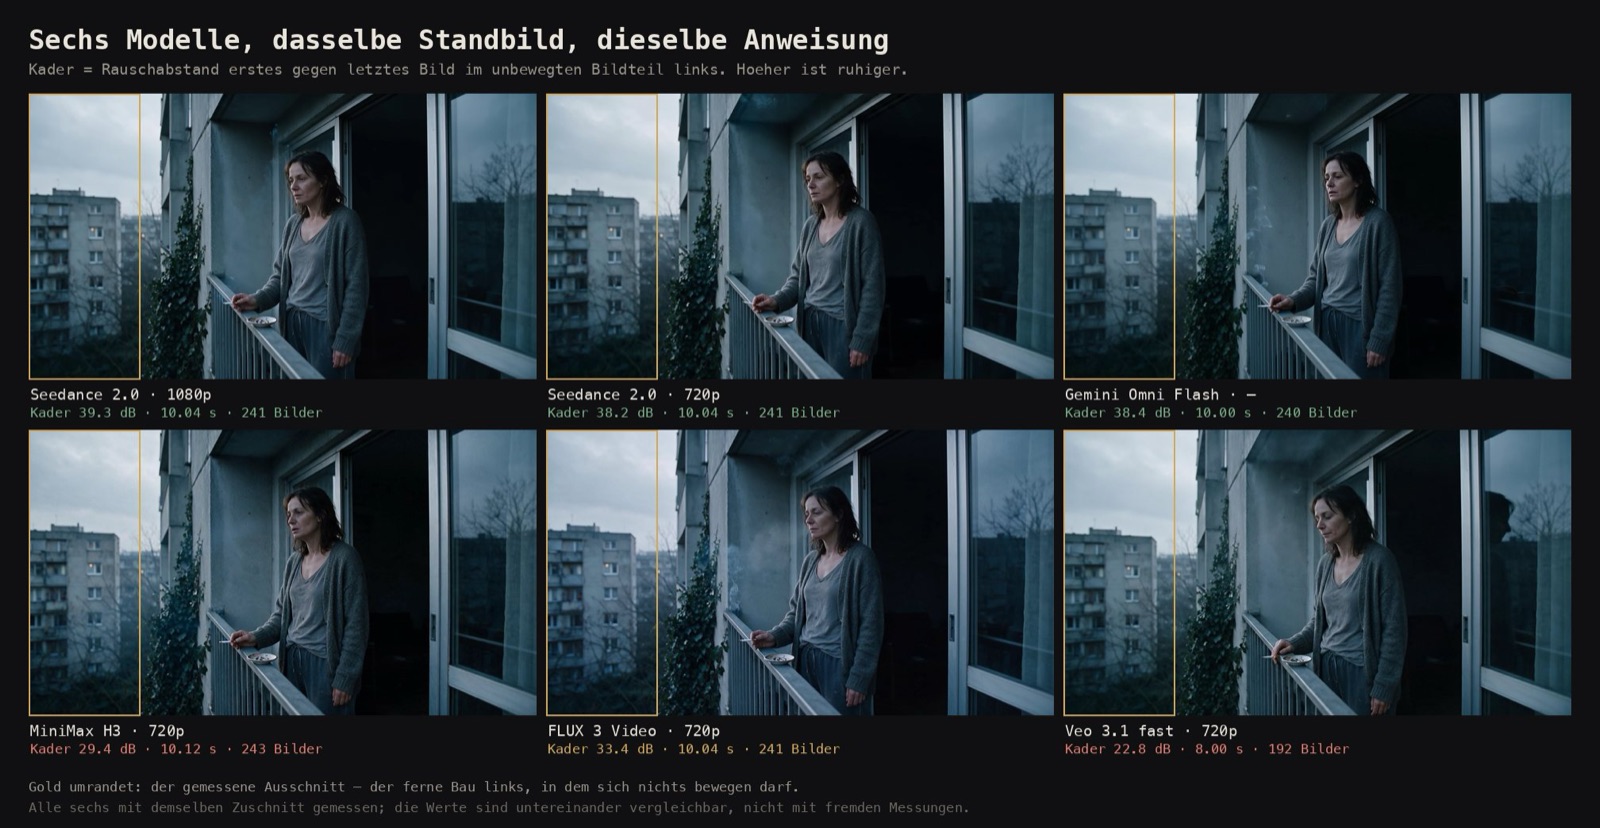
Se mide si el encuadre realmente se queda quieto: relación señal-ruido entre la primera y la última imagen en la parte inmóvil del cuadro a la izquierda, donde según la instrucción nada debe moverse. Cuanto más alto el valor, más quieta la cámara.
| Modelo | Nivel | Credits | entregado | Encuadre | Veredicto |
|---|---|---|---|---|---|
| Seedance 2.5 * | 720p | 655 | 10,04 s | 43,3 dB | quieto |
| Seedance 2.0 | 1080p | 944 | 10,04 s | 39,3 dB | se mantiene |
| Gemini Omni Flash | fest | 173 | 10,00 s | 38,4 dB | se mantiene, con audio |
| Seedance 2.0 | 720p | 420 | 10,04 s | 38,2 dB | se mantiene |
| FLUX 3 Video | 720p | 236 | 10,04 s | 33,4 dB | leve desplazamiento |
| MiniMax H3 | 720p | 83 | 10,12 s | 29,4 dB | se desplaza |
| Veo 3.1 fast | 720p | 139 | 8,00 s | 22,8 dB | se desplaza claramente, demasiado corto |
La tabla de arriba mide una sola propiedad: si el encuadre se queda quieto. Cómo se ve un modelo, no lo decide. Cuatro ejecuciones típicas, cada una sin posproducción: para mirar, no para comparar, porque son motivos distintos e instrucciones distintas.
Desde el 2 de septiembre, las mismas cuatro ejecuciones están también dentro de la mesa de trabajo, debajo de la selección de modelo en la etapa “Video”. Hasta entonces se leían ahí trece nombres de modelos con una frase de descripción cada uno y se elegía a ciegas: los archivos llevaban cuatro días listos al lado, pero nadie los había enlazado.
Todos medidos con el mismo recorte: comparables entre sí, no con mediciones ajenas. * Seedance 2.5 fue el único que corrió con una imagen inicial distinta (un interior oscuro en lugar del balcón, ver abajo). Las superficies oscuras y con poco detalle elevan el valor; por eso los 43,3 dB están junto a la lista, no dentro de ella.
El más barato no es el peor, y el más caro no es el mejor. MiniMax H3 cuesta una décima parte de Seedance en 1080p y entrega la duración completa, solo que con una cámara que se desplaza. Para una imagen de ambiente alcanza; para una secuencia con continuidad, no. Esa es justamente la elección que hace el router cuando le dices qué es lo que importa.
Se pidieron diez segundos, se entregaron ocho: ya por segunda vez. La primera vez, en 1080p, fue una observación. Con una segunda ejecución en 720p es un patrón: Veo 3.1 fast recorta, y se cobra la duración completa.
Seedance 2.5 rechaza rostros, y eso importa más que su valor máximo. El primer intento con la imagen fija del balcón fue rechazado por el proveedor: la imagen podría contener “likenesses of real people”. Muestra a una mujer generada por IA; el proveedor no puede saber que es inventada. La misma imagen la animó Seedance 2.0 dos veces sin objeciones: la restricción es nueva en 2.5.
La contraprueba responde la pregunta. El mismo modelo, el mismo encargo, pero una imagen inicial sin rostro visible: el personaje de espaldas en el sillón, con la identidad pasada como referencia en lugar de estar en la imagen. Pasó, con la duración completa, y mantuvo el encuadre más quieto que cualquier otro en la prueba. El límite no es, entonces, la capacidad del modelo, sino una restricción de contenido: para primeros planos de personajes, Seedance 2.5 no sirve en la vía i2v; para todo lo demás, es lo más estable que hemos medido. Esta distinción pertenece a la elección del modelo, no a la sorpresa en tiempo de ejecución.
Y un hallazgo que pagó esta misma ejecución: al recurrir a la alternativa, el router pasó correctamente a Veo 3.1 fast, pero se cobraron 655 Credits en lugar de 139. El fallback entrega el modelo barato y cobra el caro: 516 Credits de diferencia en un solo clip. Registrado, con reproducción y cifras, y se va a corregir.
Y la resolución rara vez vale lo que cuesta: el mismo clip en 720p en lugar de 1080p cuesta menos de la mitad, y el encuadre queda 1,1 dB por debajo, con una distancia de 16 dB entre el mejor y el más débil de los modelos. Decide la elección del modelo, no el nivel.
Imagen inicial, imagen final, imágenes de referencia, un video como referencia, audio como entrada o salida: eso varía de un modelo a otro más que el precio. Desde el 27 de septiembre, cada uno de los 42 modelos de video lleva sus roles de entrada, derivados de la misma tabla que construye la llamada, no de una descripción aparte. El campo de imagen final aparece solo donde el modelo acepta una.
La tabla encontró un error que la lista de modelos para agentes arrastraba hasta entonces: tres vías de proveedores figuraban ahí como modelos de solo texto y en realidad aceptan una imagen inicial.
Seedance 2.5 rechaza rostros también como referencia. Arriba dice que el rodeo con una imagen inicial sin rostro funciona, con la identidad como referencia. La sonda del 28 de septiembre probó la referencia misma: una imagen de referencia con rostro también se rechaza; una imagen solo de lugar pasa. Para personajes queda entonces solo Seedance 2.0, o un modelo que se desplaza.
Y el modo de edición comprime el tiempo: de 60 fotogramas de referencia salieron 58. Para un corte que debe empalmar con precisión de fotograma, eso es un error, no un detalle de redondeo.
Quien solo describe dónde está alguien rara vez lo obtiene. Quien lo ubica, lo obtiene: esto está medido, no afirmado.
Una maqueta gris marca el movimiento de cámara y el modelo debe seguirlo. Se midió cuánto se desplaza el centro de gravedad de la silueta, es decir, si la cámara realmente toma el camino planeado:
| Ejecución | El centro de gravedad se desplaza | Seguimiento de cámara |
|---|---|---|
| Plantilla de control (la maqueta misma) | 7,48 px | 100 % |
| sin ancla de imagen | 6,53 px | 87 % |
| con ancla de imagen | 1,69 px | 23 % |
El ancla de imagen era la causa. Una foto de referencia frontal se impone al movimiento de cámara: fija la imagen en lugar de llevarla consigo. Sin ella, el modelo sigue la maqueta.
Pero lo decisivo no es el porcentaje: con la maqueta, el movimiento completo necesita seis generaciones en lugar de 360. Es la diferencia entre una tarde y una semana.
Una calle con veinte personas es lo que un modelo de video arruina con más seguridad: las caras se difuminan, las personas se funden, la mitad flota en el aire. Por eso aquí los extras no se generan en el modelo, sino como una capa propia sobre el plate.
En el paso Capas del Composer: generar figuras como tarjetas, distribuirlas sobre el plate, renderizar. El plate puede ser una imagen fija o un video con movimiento de cámara; los extras, una imagen fija o un clip corto con recorte.
| Paso | Credits | qué pasa en este paso |
|---|---|---|
| Tarjeta de extras | 6 | Figura en formato vertical, con pies; si faltan, se vuelve a generar una vez a nuestro costo |
| Clip de extras | 27 | 6 s, grabados sobre verde y recortados localmente; “de pie” o “conversación”; devolución de Credits si no se genera nada |
| Trackear la cámara | 0 | para plates en movimiento; alrededor de un minuto por cada cinco segundos de plano, con veredicto “trackeable” o no |
| Oclusión, luz, render | 0 | en nuestras máquinas, 17–39 s con 12–30 figuras |
El tamaño. Sin un punto de referencia, el cálculo toma la altura de los ojos como altura de cámara; en contrapicado, la multitud quedaba por eso entre dos veces y media y tres veces demasiado pequeña. Ahora haces clic en los pies y la coronilla del personaje principal e ingresas su estatura; los extras obtienen la suya a partir de ella, 1,72 m en promedio, ajustable con un control entre 70 y 130 %.
La oclusión. Si el personaje principal está delante de la multitud, la multitud tiene que desaparecer detrás de él. Probamos cuatro modelos para la máscara de personas, uno sin falsas alarmas: ese es el que está integrado. Lo mismo para objetos: columnas, faroles y quioscos ocluyen por sí solos desde el 26 de septiembre, medido en un plate con 99,2 % recortado correctamente y 0,015 % de más.
El tracking. En cuatro plates generados con IA, la vía de reconstrucción global capturó tres por completo, la habitual paso a paso ninguno, y el tracking en Blender uno de tres. Los plates de IA son más difíciles para el tracking clásico que el material real; donde no alcanza, el veredicto dice “no trackeable”, en lugar de entregar una multitud que se desliza.
Caminar no funciona. Cero de seis clips de caminata mostraron un ciclo de marcha. La multitud está de pie o conversa; una multitud que camina queda bloqueada hasta que un modelo pueda hacerlo.
Y tres veces la corrección misma fue el error. Las figuras flotaban hasta un 7,7 % de su altura sobre el suelo, los extras medían 1,31–1,49 m en lugar de 1,72, y la cámara estaba desfasada una veinticuatroava de segundo respecto a la imagen. Cada uno de estos puntos ya se había “corregido” antes. Desde entonces, una corrección se mide antes de darla por corrección.
Depth Map. Para cada video de plate, un mapa de profundidad, cerca claro y lejos oscuro como en Resolve, gratis. Calculado con Depth Anything V2 en la versión pequeña: las más grandes están bajo una licencia que excluye el uso comercial y por eso están bloqueadas. Para objetos funciona (100 % de acierto), para personas no: ordena correctamente a las personas una detrás de otra en tres de cada cuatro imágenes, y en el caso difícil solo en una de cada dos. Por eso la máscara de personas sigue siendo una vía aparte. Por ahora, el mapa de profundidad está disponible mediante la herramienta MCP lab_depth_map y el puente con Resolve, todavía no en la app.
Magic Mask como máscara de personas. Si recortas al personaje principal en Resolve con más limpieza que la automática, envías el matte de vuelta por el puente; entonces reemplaza la máscara automática y se puede volver a desactivar. El clic en la figura lo hace una persona en Resolve: los puntos colocados por script no generaron ni una sola imagen en seis variantes.
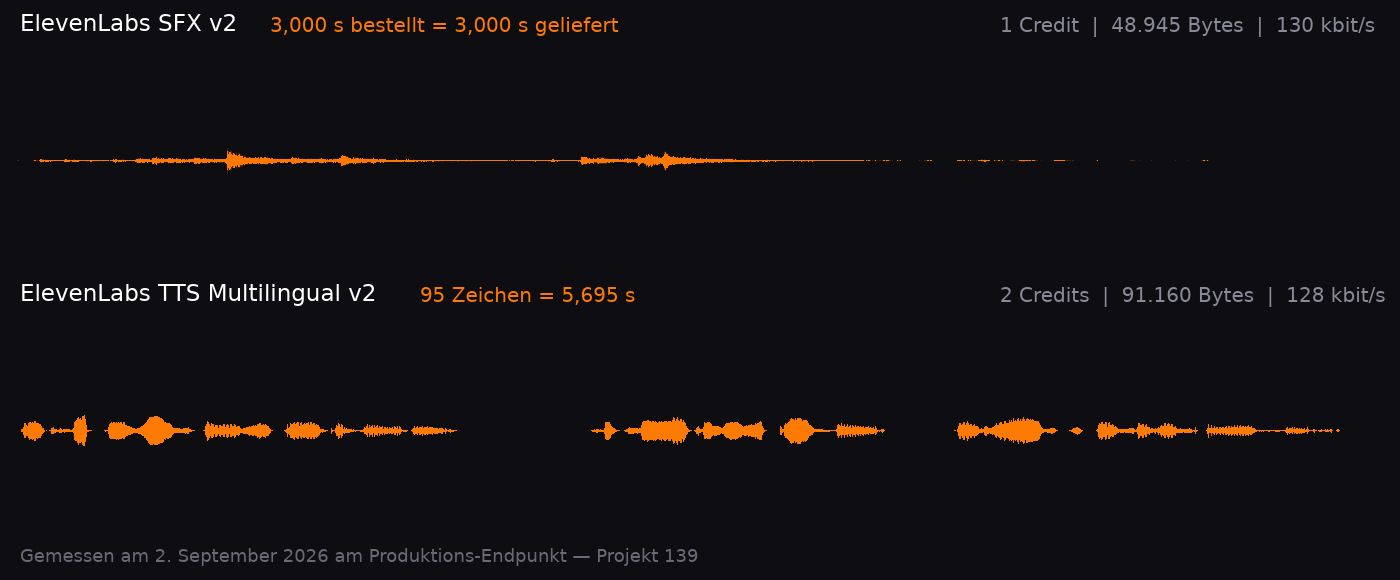
La etapa ⑧ se llama “Video + sonido”. Hasta el 2 de septiembre, la mitad de sonido ofrecía cinco herramientas y tenía una. Suno, ElevenLabs, ElevenLabs SFX y Freesound estaban en el selector y respondían con un error. Una opción de menú que no hace nada no se queja: simplemente deja de usarse, y entonces nadie lo nota.
Ahora son tres, y las tres funcionan. Se sumaron dos (ElevenLabs SFX v2 para efectos de sonido, ElevenLabs TTS Multilingual v2 para voz), desaparecieron dos: Suno no está disponible en nuestro proveedor (la búsqueda devuelve otro fabricante con un nombre parecido), y Freesound no es generación, sino una biblioteca. Buscar, revisar la licencia y llevar la atribución es otra herramienta, no una casilla en el mismo campo.
| Herramienta | cobra por | Ejemplo | Credits | para qué |
|---|---|---|---|---|
| ElevenLabs SFX v2 | segundo | 3 s | 1 | Efectos de sonido, 0,5–22 s |
| ElevenLabs TTS Multilingual v2 | 1000 caracteres | 95 caracteres | 2 | Voz, voiceover |
| Stable Audio 2.5 | Ejecución | hasta 190 s | 28 | Música, ambiente, camas largas |
Tres herramientas, tres unidades de facturación, y ese es el punto. Hasta el 2 de septiembre, cada ejecución de sonido costaba lo mismo: un precio fijo derivado de Stable Audio, porque durante mucho tiempo no hubo otra cosa. Un ruido de tres segundos habría costado así treinta veces lo que debe.
No se notó por una queja, sino al conectar las nuevas herramientas: el precio llamó la atención antes de que alguien lo pagara. En el video, lo mismo había pasado una semana antes al revés: ahí primero se pagó y después se hicieron las cuentas.
Etapa ⑨. Los planos se convierten en una secuencia. El cómputo para eso no cuesta nada: aquí no se genera nada, se ordena.
Doce presets de look llevan nombres de películas en lugar de valores de color: Blade Runner 2049, In the Mood for Love, Grand Budapest Hotel, 2001, Chinatown, Tree of Life, Amélie, Mad Max: Fury Road, Moonlight, Parasite, Drive, Stalker. No es coquetería: quien dice en la sala de montaje “hazlo más como Moonlight” es entendido, y un par de números para temperatura de color y saturación no lo es.
| Block | Duración | qué es |
|---|---|---|
| Título | 5 s | Título y subtítulo; vacío significa título del proyecto |
| Créditos finales | 8 s | Rol y nombre, línea por línea |
| KI-Kennzeichnung | 4 s | Obligatorio según el art. 50, apdo. 4 del Reglamento de IA |
El tercer bloque no es una opción. El art. 50, apdo. 4 del Reglamento de IA exige divulgación cuando hay personas generadas por IA. Por eso no está en una lista de verificación que se puede tachar, sino como bloque junto al título y los créditos finales: en el mismo lugar donde ya se trabaja, con texto preformulado y cuatro segundos en pantalla.
Nota honesta del 28 de septiembre: “Obligatorio” es en este bloque una etiqueta, no un bloqueo: una exportación sin él no se rechaza. Lo que no se puede desactivar está desde el 25 de septiembre un nivel más abajo: cada render con material de IA lleva la marca en la imagen y en el archivo, esté o no el bloque. Más sobre esto en Procedencia.
En Murnau, a la derecha del área de montaje, hay una columna propia con tres líneas de entrada (montaje, VFX, sonido) y, encima, un pequeño signo y el nombre IRO. Hasta el 17 de septiembre de 2026 ahí decía “AI”. El nombre anterior remitía a Lotte Reiniger, que en 1926 hizo con Die Abenteuer des Prinzen Achmed el primer largometraje de animación, con papel negro recortado, iluminado desde atrás y con los fondos coloreados a mano. Desde octubre de 2026 el asistente se llama IRO.
Desde el 22 de septiembre de 2026, el signo es un corredor: cinco bandas oscuras que se desplazan hacia afuera, sobre un disco luminoso en naranja brasa. Las bandas recorren en 21 segundos seis tonos profundos (marrón oscuro, carmín, violeta, azul noche, petróleo, verde abeto), y en sus bordes corren dos franjas de color en sentidos opuestos, igual que un objetivo refracta el rojo y el azul de manera distinta. No son colores espectrales, como decía aquí hasta el 28 de septiembre: sobre el naranja claro, ninguno mantenía suficiente contraste, medido de 1,04:1 a 2,64:1. Oscuro sobre luz: ese sigue siendo el principio de Reiniger.
Las temporadas se quedaron, a diferencia de lo que decía aquí hasta el 28 de septiembre: Halloween, Navidad, Pascua y Fin de Año tiñen el disco; la figura sigue siendo la misma. La Berlinale solo existe mediante ?saison=berlinale: la fecha de un festival no sigue ninguna fórmula. ?saison=aus fuerza el tono base.
El signo también dice qué está pasando. En reposo, una banda tarda cinco segundos en salir; mientras responde, 1,35; mientras lee, va hacia atrás: recibe en lugar de enviar. Si hay una propuesta pendiente, el corredor se enrolla en una espiral que se desenrolla a lo largo de la validez de la propuesta (15 minutos). Cuando llega al centro, la propuesta ha caducado. Si no quieres ver movimiento, con el ajuste del sistema obtienes una imagen fija con plena intensidad.
Hasta el 19 de septiembre de 2026, en esta única línea había tres botones. Apply enviaba el texto a un clasificador, Preguntar al asistente, Inspire ni siquiera era un modelo, sino una lista, y elegía al azar una de seis frases fijas. Es decir, el usuario tenía que decidir antes de escribir si quería cambiar o preguntar. Esa es una decisión que solo se puede tomar después de la respuesta.
Ahora todo va a IRO. Eso funciona solo desde que IRO es capaz de proponer varios cortes de una vez y conoce los controles: antes, un verbo habría costado la capacidad de ajustar cualquier parámetro con una instrucción. Primero la herramienta, luego el manejo.
Las seis sugerencias aparecen como opciones debajo del campo vacío y desaparecen en cuanto escribes. Una sugerencia junto a una frase a medio escribir ya no es una oferta, sino una distracción.
En las tres superficies estaba el mismo asistente, aunque FilmRadar tiene desde julio todo un reparto: diez oficios y veinte versiones de board, con nombre, trayectoria y forma de pensar. Solo que Murnau no tenía acceso a ellos.
| Área | Quién está ahí | Oficio |
|---|---|---|
| Montaje | Tarek Mansouri | Editor de cine, piensa en ritmo, elipsis, contrastes |
| Ton | Rafael Duarte | Compositor y sound designer, piensa ambas cosas como una unidad |
| VFX | Anders Marder | Dirección de fotografía: luz, textura, color, espacio |
El signo sigue siendo del asistente. El corredor de luz es la firma de la asistencia, no la identificación de una persona; ahora lleva tres nombres. Si la Registry falla, vuelve a aparecer “IRO”: la asignación es un enriquecimiento, no la operación. Un editor que deja de responder porque una base de datos ajena se traba sería un mal canje por un nombre.
En el registry son evaluadores: aquí trabajan. Cada persona termina con “Responde SIEMPRE como JSON con exactamente estos campos: score, headline, strengths, concerns”. Así están construidas para el nivel de veredicto de ScriptLab. Para Murnau se recorta justamente esa parte: viaja solo la persona, no el formulario. Una operadora que responde a cada instrucción con una nota sería inútil, y lo haría, porque un contrato en el prompt pesa más que cualquier petición posterior.
Durante un día, el signo tuvo cinco estados: tijera, tira de película, corte terminado, arco roto. A 36 píxeles era el escenario equivocado: lo que distingue lee, te espera y falló necesita palabras, no una silueta. Y la estrella de la propuesta terminada estaba a treinta píxeles de la estrella del botón Inspire.
Hoy son cuatro estados de una sola figura (lista, pensando, leyendo, propuesta), que se distinguen solo por el movimiento, nunca por un símbolo. Todo lo preciso está junto al campo, donde el ojo ya está al escribir y donde hay todo el ancho disponible: una barra en el borde inferior del campo mientras trabaja, y la línea de abajo para la respuesta, las herramientas consultadas y los errores.
El /ai/interpret de Murnau tenía tres system prompts escritos a mano, cada uno con su propia lista de lo imposible. Medida el 2026-09-17, la versión de montaje estaba equivocada en cuatro de cinco puntos: declaraba imposibles cortar, borrar, reordenar y las transiciones, aunque las cuatro están en el editor.
Para el usuario, eso no parece un límite de la interfaz, sino un límite del producto. Pregunta una vez, lee “no existe” y no vuelve a preguntar. Una lista en prosa se vuelve obsoleta porque ningún guardián puede comparar dos frases; esta no se vuelve obsoleta, porque cada entrada lleva una prueba que scripts/ci/check_playbook_belege.py consulta en cada pull request, y en ambas direcciones. Si construyes splitClipAtFrame y dejas la entrada en nein, queda en rojo.
Desde el 25 de septiembre, IRO también está a la derecha en el Composer, el Taller con las diez etapas. Ahí IRO lee lo que una persona consultaría antes de decidir: dónde está el proyecto, cuánto cuesta un paso, qué incluye cada plan, cuánto saldo queda. Cuando se nombra una etapa, es por su nombre y no por la clave interna: en la aprobación eso apareció mal una vez.
Propone en lugar de actuar, y distingue dos tipos:
Si no puede consultar el precio con certeza, no hay propuesta pagada: un botón sin cifra no se construye. De todos modos, solo se ejecuta aquello en lo que haces clic.
Si una pregunta necesita un departamento, IRO lo suma por su nombre: uno de los diez roles del equipo, como máximo dos por respuesta. Si falla la asignación, IRO responde directamente en lugar de quedarse en silencio. Y en Murnau, desde el 24 de septiembre, IRO lleva un registro: las últimas doce respuestas, la más reciente arriba; antes, cada respuesta borraba la anterior. Cada paso en él indica su duración, también el que falló.
Con el puente de Resolve también conoce la timeline abierta de Resolve y puede proponer ahí profundidad y Magic Mask. Un clip no lo propone ahí: para eso haría falta una imagen de origen que en ese punto no existe.
Si IRO dice algo incorrecto, se puede retirar. La retractación no queda como borrado, sino como corrección junto a la fuente: un dato falso borrado vuelve en la siguiente ingesta, uno corregido no. La corrección lleva el nombre de quien la escribió: sin identidad no hay vía de escritura, y lo que tú corriges no lo ve nadie más.
Bajo cada una de las tres barras hay una fila de deslizadores. Parecen controles, y hasta el 19 de septiembre de 2026 no lo eran: el valor pasaba a un objeto, el objeto viajaba como sliders con el encargo, y en el prompt terminaba como una línea desnuda:
{"pace":100,"tension":50,"rhythm":50,"flow":75}
sin unidad, sin escala, sin una palabra de explicación. Pace 0 y Pace 200 generaban la misma instrucción. Lo que el modelo dedujera de eso era cuestión de suerte.
| Control | Rango · Predeterminado | alto significa | bajo significa |
|---|---|---|---|
| Pace | 0–200 · 100 | ajustar: quitar tiempos muertos, cortar antes | dejar aire, dejar las pausas |
| Tension | 0–100 · 50 | cortar en el movimiento, acortar hacia el final | dejar respirar, dejar que se apague |
| Rhythm | 0–100 · 50 | duraciones parejas, al compás | desigual a propósito: largo contra corto |
| Flow | 0–100 · 75 | transiciones suaves, cortes J y L | cortes duros, dejar las rupturas |
| Control | Rango · Predeterminado | alto significa | bajo significa |
|---|---|---|---|
| Intensity | 0–100 · 100 | desplegarlo por completo | contenerlo: apenas insinuado |
| Blend | 0–100 · 100 | integrado: grano, color y luz igualados | visiblemente superpuesto, como elemento propio |
| Detail | 0–100 · 50 | cabello y bordes limpios: más lento, más caro | mantenerlo tosco |
| Edge | 0–100 · 75 | borde duro y preciso | suave y deshilachado: correcto con desenfoque de movimiento y cabello |
| Control | Rango · Predeterminado | alto significa | bajo significa |
|---|---|---|---|
| Loudness | −24…0 · −14 | más fuerte, hacia 0: extremo social | más suave: cine y archivo |
| Dynamics | 0–100 · 50 | mantener separados lo suave y lo fuerte | comprimir: volumen parejo |
| Clarity | 0–100 · 60 | la voz adelante, el ruido atrás | dejar el espacio sin retocar |
| Depth | 0–100 · 40 | admitir reverberación y profundidad | seco y cercano |
El loudness no es cuestión de gusto, sino una norma. Son LUFS, y los valores objetivo ya están más abajo en este manual: −14 para web y YouTube, −12 para redes sociales, −24 para cine y archivo. Quien mueve ese control elige una norma de entrega, no un color de sonido.
Justamente este control se pasó por alto dos veces al hacer el inventario: es el único con rango negativo, y la medición que debía encontrarlo no admitía el signo menos. Un control con rango negativo, en un conteo que solo conoce números positivos, parece no existir. Lo encontró el vigilante en la primera ejecución.
Solo desviaciones. Un control en su valor predeterminado no es una instrucción, sino la ausencia de una: si aun así apareciera en el texto, la única desviación que importa quedaría escondida entre tres irrelevantes. Si todos están en el valor predeterminado, el modelo recibe la frase “decide según el material”.
Cada barra envía su propio grupo. Pace y Tension no le dicen nada a un encargo de compositing; antes, la barra de VFX recibía los significados de edición y no encontraba en ellos ni uno solo de sus nombres.
Y el significado está en un solo lugar, para ambas vías: el clasificador rápido y el bucle de herramientas. Un control que vale en una vía y no en la otra es peor que uno que no vale en ninguna: lo mueves, ves un efecto, y la próxima vez no aparece.
Debajo de la timeline hay una pista adicional, rotulada CUES. Responde una pregunta que nadie más hace porque es demasiado laboriosa: ¿Lo que dice el prompt pasó realmente en la imagen?
Un cue es una afirmación individual del prompt, ligada a una ventana en el corte. “Corte seco en 00:01.50, cámara sobre el héroe, medium” es un cue. No está al lado como comentario, sino sobre los fotogramas para los que rige, y así se puede comparar con lo que realmente se ve ahí.
Diez tipos, y dos de ellos se comportan distinto de los otros ocho. Los primeros ocho vienen de SceneFlow y se aplican cada uno a una ventana de tiempo: dialogue, action, camera, shot, audio, vfx, transition, environment.
Los otros dos se aplican al clip completo. regel proviene de POSITIVE CONSTRAINTS o de RULES (“exactamente tres personas, ninguna cuarta”), referenz, frase por frase, de ACTIVE REFERENCES (“@Video1 es la única autoridad para cámara, cortes y timing”). Una regla no tiene una ventana en la que rige: rige siempre. Por eso ambos aparecen en la pista de la izquierda como conteo (@ 9 · § 7) y no como bloque en un lugar.
Cada cue lleva un veredicto. Hay cuatro posibles, y la diferencia entre los dos últimos es la que importa:
| Hallazgo | Significado | Lo que dice sobre el modelo |
|---|---|---|
offen | nadie lo ha revisado todavía | nada: no es una afirmación, sino su ausencia |
da | está así en la imagen | la instrucción llegó |
fehlt | no aparece en la imagen | la instrucción fue ignorada |
anders | algo pasa, pero no eso | la instrucción fue entendida y reinterpretada |
La separación no es una minucia. fehlt se cura con insistencia: la instrucción más clara, antes, repetida. anders nunca se cura así: el modelo leyó el pasaje y decidió otra cosa. Ahí solo sirve reescribir la instrucción. Quien mete ambas cosas en la misma bolsa prueba el remedio equivocado hasta que considera que el modelo no sirve.
La etiqueta de la pista nombra siempre primero lo que está pendiente: “12 pendientes · 31 presentes · 6 faltan · 2 distintos (79 %)”. Una tasa que calla doce cues sin revisar se lee como un resultado y es un informe intermedio.
En el encabezado de la vista del prompt dice “19 de 19 posición(es) marcada(s)”. Los dos números parecen tener que ser iguales. No lo son, y la diferencia es todo el sentido de la indicación.
El segundo número pertenece al clip de origen y conoce todos sus cues. El primero pertenece a esta aparición en el corte, y un clip recortado no contiene los beats fuera de su ventana. El 18 de septiembre de 2026 el encabezado reportaba “19 posiciones marcadas”, pero había 17 dibujadas: la aparición estaba recortada a 19 de 96 fotogramas, y dos de los tres beats quedaron fuera. El número era correcto para el clip de origen y mentía sobre lo que había en pantalla.
Los que faltan se nombran, no se callan. Si detrás del balance dice “· 2 fuera de este corte”, esa es la información que necesita quien edita. Sin ella, compara el prompt con la vista, encuentra dos posiciones de menos y busca el error en sí mismo.
El prompt cambia, los cues se vuelven a leer a partir de él, y los veredictos se perderían. No se pierden: un hallazgo está ligado a tipo, redacción y ventana de tiempo, no a la posición en el texto.
Los offsets de caracteres expresamente no cuentan. Se desplazan en cuanto se agrega un carácter en otra parte del prompt, y un veredicto no se refiere al lugar donde está una frase, sino a lo que dice. Lo que no se vuelve a encontrar no se descarta en silencio: la respuesta indica befunde_übernommen y befunde_verworfen, para que una pérdida se note en lugar de disfrazarse de pista vacía.
Lo que la pista no hace: juzgar. Los cues los lee del prompt, la ventana la calcula a partir del corte; el hallazgo lo asigna una persona que miró la imagen. No hay aprobación automática ni una tasa que surja sola. Una máquina que califica su propia fidelidad a las instrucciones califica su propia lectura del prompt.
Hasta el 23 de septiembre, la persona en Murnau y un agente vía MCP veían dos montajes distintos de la misma secuencia. Guardar en el editor escribía en la propia sesión; el agente leía en otro lugar.
Ahora cada guardado, también el automático, escribe el montaje donde lee el agente. Si con eso sobrescribe trabajo del agente, la línea de guardado dice qué se perdió (“3 clips del agente sobrescritos (8 s, 2 transiciones, 2 pistas de audio)”) y antes crea un estado desde el que se puede recuperar. Hacía falta: el 24 de septiembre, un solo clic sobrescribió una secuencia con un clip, porque el editor, con diez secuencias en el proyecto, había adivinado cuál era. La salvó el estado. Desde entonces ya no adivina: si el destino no está claro, pregunta.
La lista de montaje como tabla: pista, entrada y salida de origen, entrada en la timeline, duración, fuente, plano, en timecode. Solo pistas de imagen.
Darle un nombre a un estado: en la cabecera “Estados”, luego “Guardar estado”. Las versiones con nombre nunca caen bajo el tope de 50 estados automáticos ni cuentan para él.
La lista de estados y, para cada uno, a pedido: ¿qué cambió? Quién lo cambió, tú o un agente, aparece al lado.
Ver sí; recuperar desde esta lista, todavía noLo que está después del punto de inserción se desplaza la duración completa; un clip que cruza el punto se divide. Antes, el botón superponía: ver arriba.
Una secuencia se puede exportar como OTIO y volver a importar, por ejemplo de regreso desde otro programa de edición. El regreso siempre crea una secuencia nueva y no sobrescribe nada; el identificador de cada clip viaja con él, para que siga siendo el mismo allá y aquí.
Exacto al fotograma, no idéntico al bit. 5,5 segundos vuelven como 5,52: 138 fotogramas a 25 fps, porque medio fotograma pertenece a la duración y no puede desaparecer. Si un clip se divide del otro lado, solo el primer trozo conserva su identificador.
Y dónde está el botón: todavía en ninguna parte. Ambas direcciones están construidas y probadas; hoy se accede a ellas por la interfaz de programación, no por la interfaz de usuario.
El puente de Resolve corre dentro de DaVinci Resolve, no al lado. No es una cuestión de estilo: Resolve de la App Store no se puede controlar por script desde afuera; la interfaz simplemente no responde, medido el 12 de septiembre. Desde adentro sí funciona.
Desde el 27 de septiembre, el puente y el servidor MCP forman una fachada común. Un agente, por ejemplo Claude en el escritorio, ve así FilmLab y la timeline abierta al mismo tiempo. Incluye un visor que muestra la imagen bajo el cabezal de reproducción y puede superponer un mapa de profundidad con una cortinilla: construido, pero todavía no aprobado en cada programa de agentes.
| Página | Herramientas | de ellas, de escritura |
|---|---|---|
| FilmLab (MCP) | 82 | Generar, corrección de color, profundidad, montaje: las pagadas solo con aprobación |
| Resolve (puente 0.67) | 14 | 3: hacer tracking con Magic Mask, exportar el mate, resultado a la timeline |
Cada una de las tres herramientas de escritura de Resolve crea antes un duplicado de la timeline. Un agente que trabaja en tu montaje no debe poder perderla.
El clic lo hace una persona. Magic Mask se puede trackear y exportar por script, pero no iniciar: puntos colocados en seis variantes no generaron ni una sola imagen. Hacer clic en la figura tienes que hacerlo tú.
Y tres límites del primer día: el tracking solo funciona con la página Fusion abierta; el diálogo “Render completed” detiene Resolve hasta que alguien lo cierra; y una llamada tiene veinte segundos antes de que el agente se rinda.
Dos pasos donde cuesta dinero. Un agente recibe primero el precio en Credits y euros, y luego un identificador de aprobación que vale exactamente para esa llamada con exactamente esos datos, una vez y durante quince minutos. No existe una puerta trasera para ejecutar código arbitrario en Resolve.
Etapa ⑩. Tampoco cuesta Credits: se procesa en nuestras máquinas, no en un proveedor de modelos.
Una exportación no es “un archivo en una resolución”. Es un paquete de espacio de color, rango dinámico, códec, contenedor y sonoridad, y la sonoridad es la cifra en la que fracasan la mayoría de las entregas, porque en el programa de edición no se nota.
| Destino | Espacio de color | Codec | Resolución | Sonoridad |
|---|---|---|---|---|
| Web / FrameZero | sRGB · SDR | H.264 / MP4 | 1080p | −14 LUFS |
| Redes sociales (IG/TikTok) | sRGB · SDR | H.264 / MP4 | 1080×1920 | −12 LUFS |
| YouTube | Rec.709 · SDR | H.264 / MP4 | 2160p | −14 LUFS |
| Streaming HDR | Rec.2020 · HDR10 | H.265 / MP4 | 2160p | −14 LUFS |
| Proyección en cine | DCI-P3 · HDR | ProRes / MOV | 4K DCI | −24 LUFS |
| Archivo / máster | Rec.2020 · HDR | ProRes 4444 | 4K | −24 LUFS |
La sonoridad es la diferencia que duele. Hay diez decibeles entre redes sociales y cine: −12 frente a −24 LUFS. Quien sube una mezcla de cine a Instagram queda con el volumen bajado y suena delgada; quien entrega al revés no pasa la aprobación. Es la misma secuencia, y son dos archivos distintos.
En los seis destinos hay tres niveles de calidad: Draft (mitad de resolución, para una mirada rápida), Standard y High Quality (el doble). El nivel cambia la resolución y la tasa de datos, no el perfil: el espacio de color y la sonoridad se quedan donde los pone el destino.
Un canal de televisión, un festival, una entidad de fomento pregunta en algún momento: ¿qué hay de IA en esta película y quién lo aprobó? Desde el 26 de septiembre, la respuesta está junto a cada archivo de la película, y se puede verificar sin confiar en nosotros.
Con cada exportación se genera una constancia de procedencia, en PDF para leer y en JSON para máquinas, con un enlace a la página de verificación. Está junto al archivo de la película, no dentro de él: una constancia metida en el archivo cuya suma de verificación indica sería circular.
| Qué contiene | Lo que nunca se hace público |
|---|---|
| Suma de verificación del archivo de la película, duración, si el etiquetado está en la imagen, aprobación con fecha | Prompts: solo los ve quien es dueño del proyecto |
| por clip: timecode, fuente, tipo (p. ej., imagen a video), herramienta, proveedor, momento de generación | Identificadores de consentimiento, correo electrónico, cuenta |
La verificación se hace en seal.thefilmradar.com/herkunft: arrastras el archivo, el navegador calcula su suma de verificación y no se sube nada. La constancia está firmada con una clave cuya mitad pública está ahí, además de dos sellos de tiempo, uno de ellos anclado en la blockchain de Bitcoin. Quien no nos crea lo verifica con OpenSSL por su cuenta; las instrucciones están en la página.
Cada render con material de IA lleva abajo a la derecha la marca “Modificado con IA” y en el archivo la anotación legible por máquina según IPTC. Que hasta el 25 de septiembre eso no era cierto en Murnau, aunque la base de datos lo afirmaba, está arriba. Se notó solo cuando alguien revisó el archivo en lugar del campo.
Si una exportación contiene una persona generada (un clip basado en un personaje) o una voz generada (voz en off, diálogo, doblaje), se detiene antes de exportar y pide una frase:
“Revisé esta exportación y la apruebo. Contiene personas o voces generadas o modificadas de forma sintética.”
Se registran la cuenta, el momento y la versión de este texto; la página de verificación solo muestra la fecha. El audio que un modelo de video entrega por sí mismo no activa ninguna aprobación. Y solo puede aprobar una persona con sesión iniciada en la interfaz: un agente vía MCP recibe aquí un rechazo. Una frase que dice “lo revisé” no vale nada si una máquina puede firmarla.
Lo que la constancia no acredita, y eso también figura en la página de verificación. Los timecodes valen para la exportación desde FilmLab, no para la versión emitida; entre ambas están conform, corrección de color y transcode. La clasificación por clip sigue lo que el sistema registró al generar, no el juicio de una persona, y donde no registró nada, dice “no registrado”, no una suposición.
Y lo que no es: no es un certificado C2PA con cadena hasta una entidad de certificación. Es una constancia propia y publicada. Las versiones dobladas que se generan por la vía rápida todavía no reciben una. Se conserva en versión reducida durante diez años después del fin del contrato, para que siga siendo verificable incluso cuando el proyecto se haya borrado hace mucho.
No toda medición termina en una función. Algunas terminan cerrando una vía, y esa es la forma más barata de ahorrar dinero.
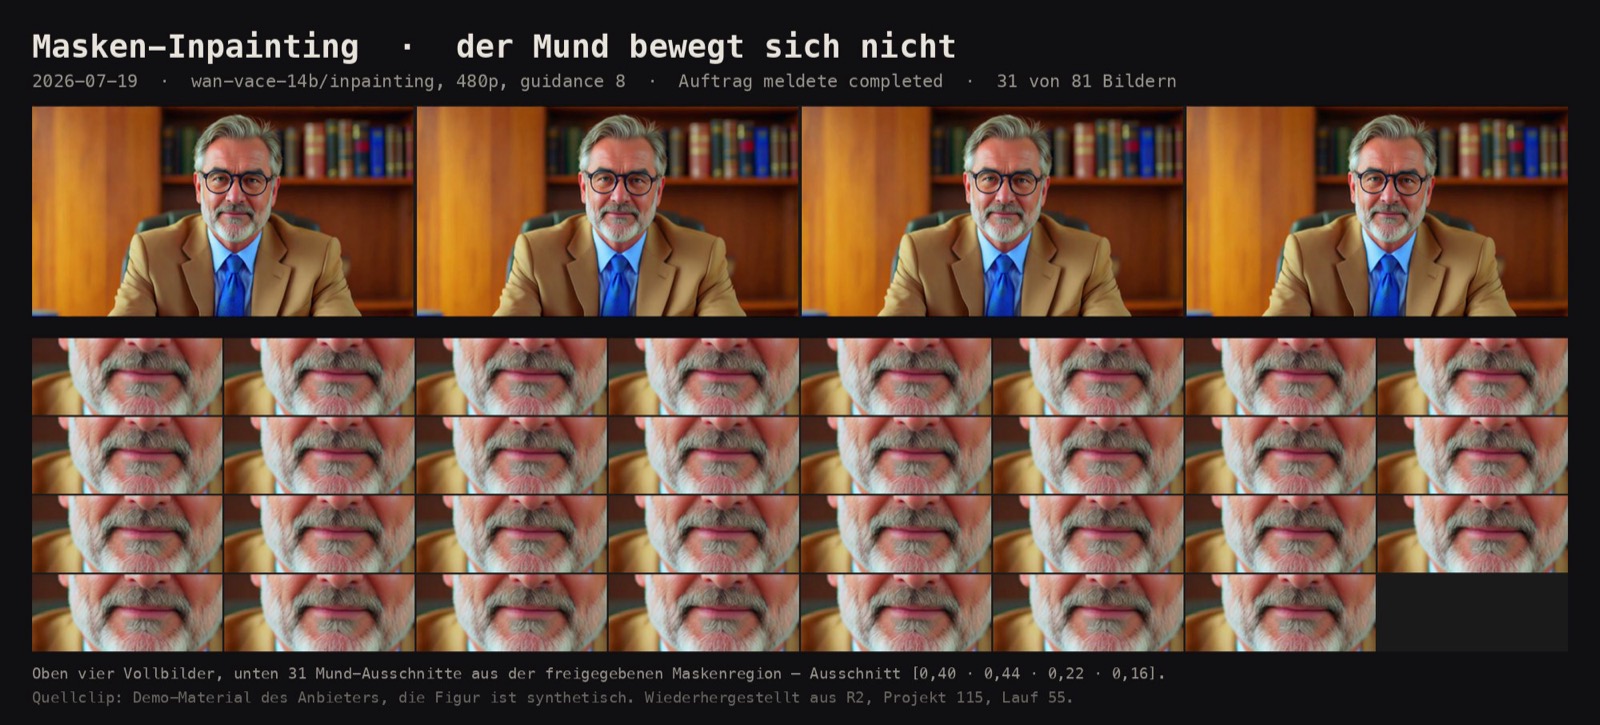
La pregunta del 19 de julio: ¿se puede regenerar por máscara una región de la boca liberada para el movimiento de los labios, mientras el resto de la imagen se queda quieto? Tres ejecuciones pagadas en las que se cambió exactamente una variable:
| Ejecución | Máscara | Estado del trabajo | Efecto visible |
|---|---|---|---|
| Borrador | imagen estática | completed | ninguno |
| alta calidad | imagen estática | completed | ninguno |
| Sucesor | video de máscara real, alineado fotograma a fotograma | completed | ninguno |
Los tres reportaron éxito. La boca siguió cerrada en los tres: lo comprobamos en una hoja de contactos de 31 fotogramas, una vez completa y otra como recorte de la boca. Sin esa mirada, la vía habría pasado a la pipeline como “funciona”.
Desde entonces, la lección está por encima de todo lo que hay aquí: que un proveedor documente un campo no significa que ese campo tenga efecto. El código de estado dice que algo se ejecutó. Si hizo algo, solo lo dice la imagen.
Dos presets hicieron algo que nadie había pedido. Ambos errores estaban en la formulación, no en el modelo, y las dos versiones anteriores siguen disponibles, para que a nadie se le quite nada de las manos.
El filtro de contenido de los modelos de imagen es parte de la planificación de producción. A una figura cuya descripción incluye una autolesión (porque la escena la incluye) le rechazaron seis de seis planos. En otra figura falló exactamente un plano, y seis veces seguidas: la combinación de “manos temblorosas, postura rígida como con respiración mecánica” y “caminando hacia la cámara” la interpreta el revisor como una emergencia. No es un error aleatorio que se resuelve con un segundo clic.
No reescribimos esas descripciones para engañar a un filtro. La figura pertenece al guion, no al proveedor. Lo que hacemos en cambio: nombrar el fallo. Desde el 2026-09-02, la respuesta dice expresamente qué planos no se generaron; antes simplemente faltaban en la lista, y una hoja a medias parecía completa.
Y para niños el sistema no describe anatomía: a propósito. Para adultos incluye la edad automáticamente como anatomía en cada indicación: a los treinta y cuatro, “primeras arrugas finas en la frente, línea de la mandíbula todavía firme”; a los setenta y siete, “rostro profundamente surcado, párpados caídos, manchas de la edad”. Por debajo de dieciocho no incluye nada, y eso no es un hueco, sino un límite fijado de este producto.
El precio de eso es real y debe estar aquí: una niña de diez años volvió dos veces como una de cinco, aunque su descripción indicaba proporciones de diez años. Donde la descripción es escasa, el modelo pone su propia edad, y contra eso en este punto solo ayuda un trabajo manual preciso en los campos de la figura, y mirar.
La dispersión es real. El mismo prompt a veces funciona al primer intento y a veces recién al segundo. Un fallo en un cambio de estilo fuerte casi nunca es un error del preset, sino un segundo clic.
Y un límite que ninguna regla de texto cierra: los errores de contenido. Un overlay puede llamar “SEDAN” a un auto compacto hatchback: una palabra real, bien escrita y equivocada. Eso solo se nota mirando.
Planes, precios de Credits, claves propias y puestos de equipo están en el manual, en “Precios”: en un solo lugar, consultados en vivo, para que no diverjan en dos sitios. Aquí solo lo que se midió y por qué el modelo de costos es así.
Hasta la mañana del 28 de septiembre, aquí decía en Studio “tres puestos, proyectos compartidos, cola prioritaria”; nada de eso estaba construido, y la línea se eliminó. Desde esa noche, ambas cosas existen.
Quién paga figura en cada cargo. Lo que un miembro lanza en el Studio se descuenta del saldo del Studio y lleva el nombre del miembro; los Credits devueltos vuelven a donde se hizo el cargo, aunque la membresía ya haya terminado. La vía de devolución anterior acreditaba a quien había lanzado el encargo: en el Studio, eso habrían sido Credits del Studio en la cuenta del miembro.
Y una puerta que se cerró en el proceso: en Murnau, hasta el 28 de septiembre, cualquier cuenta con sesión iniciada podía abrir cualquier proyecto que se hubiera entregado desde el Composer. El propio código fuente decía que eso solo aguantaba hasta el primer uso multiusuario real. Ahora decide el dueño del proyecto de Composer.
Hasta el 28 de septiembre, aquí decía “una imagen 5–6 Credits, una pista de audio 30”; lo de la imagen valía solo para dos modelos, y la pista de audio era desde el 2 de septiembre más barata de lo que decía esta página. Desde entonces: una imagen, según el modelo, de 3 a 21; una pista de audio, 28.
Hasta el 26 de septiembre, la línea de costos mostraba el precio de compra en el proveedor del modelo. Era una cifra con la que nadie paga nada; desde entonces muestra Credits y el rango en euros que cuesta un Credit según la forma de compra.
El factor seis está entre modelos, no entre proveedores. Medido: el mismo clip de diez segundos en 720p cuesta con un modelo alrededor de seis veces lo que cuesta con el otro. Por eso el producto es el router y no el zoológico de modelos.
El precio aparece antes de enviar. No es una comodidad, sino una lección pagada: un día de prueba sin preflight costó 45 US$ donde habrían bastado 7,50 US$.